数据处理
本文详细介绍了 Milvus 中数据插入、索引建立和数据查询的实现。
数据插入
您可以为 Milvus 中的每个 Collection 指定若干分片,每个分片对应一个虚拟通道*(vchannel*)。如下图所示,Milvus 会为 Log broker 中的每个 v 通道分配一个物理通道*(pchannel*)。任何传入的插入/删除请求都会根据主键的哈希值路由到分片。
由于 Milvus 没有复杂的事务,因此 DML 请求的验证工作转到了 Proxy。Proxy 会向 TSO(时间戳分配服务) 请求每个插入/删除请求的时间戳,TSO 是与 RootCoord 共用的计时模块。旧的时间戳会被新的时间戳覆盖,时间戳用于确定正在处理的数据请求的顺序。Proxy 从 DataCoord 分批检索信息,包括实体的分段和主键,以提高总体吞吐量,避免中央节点负担过重。
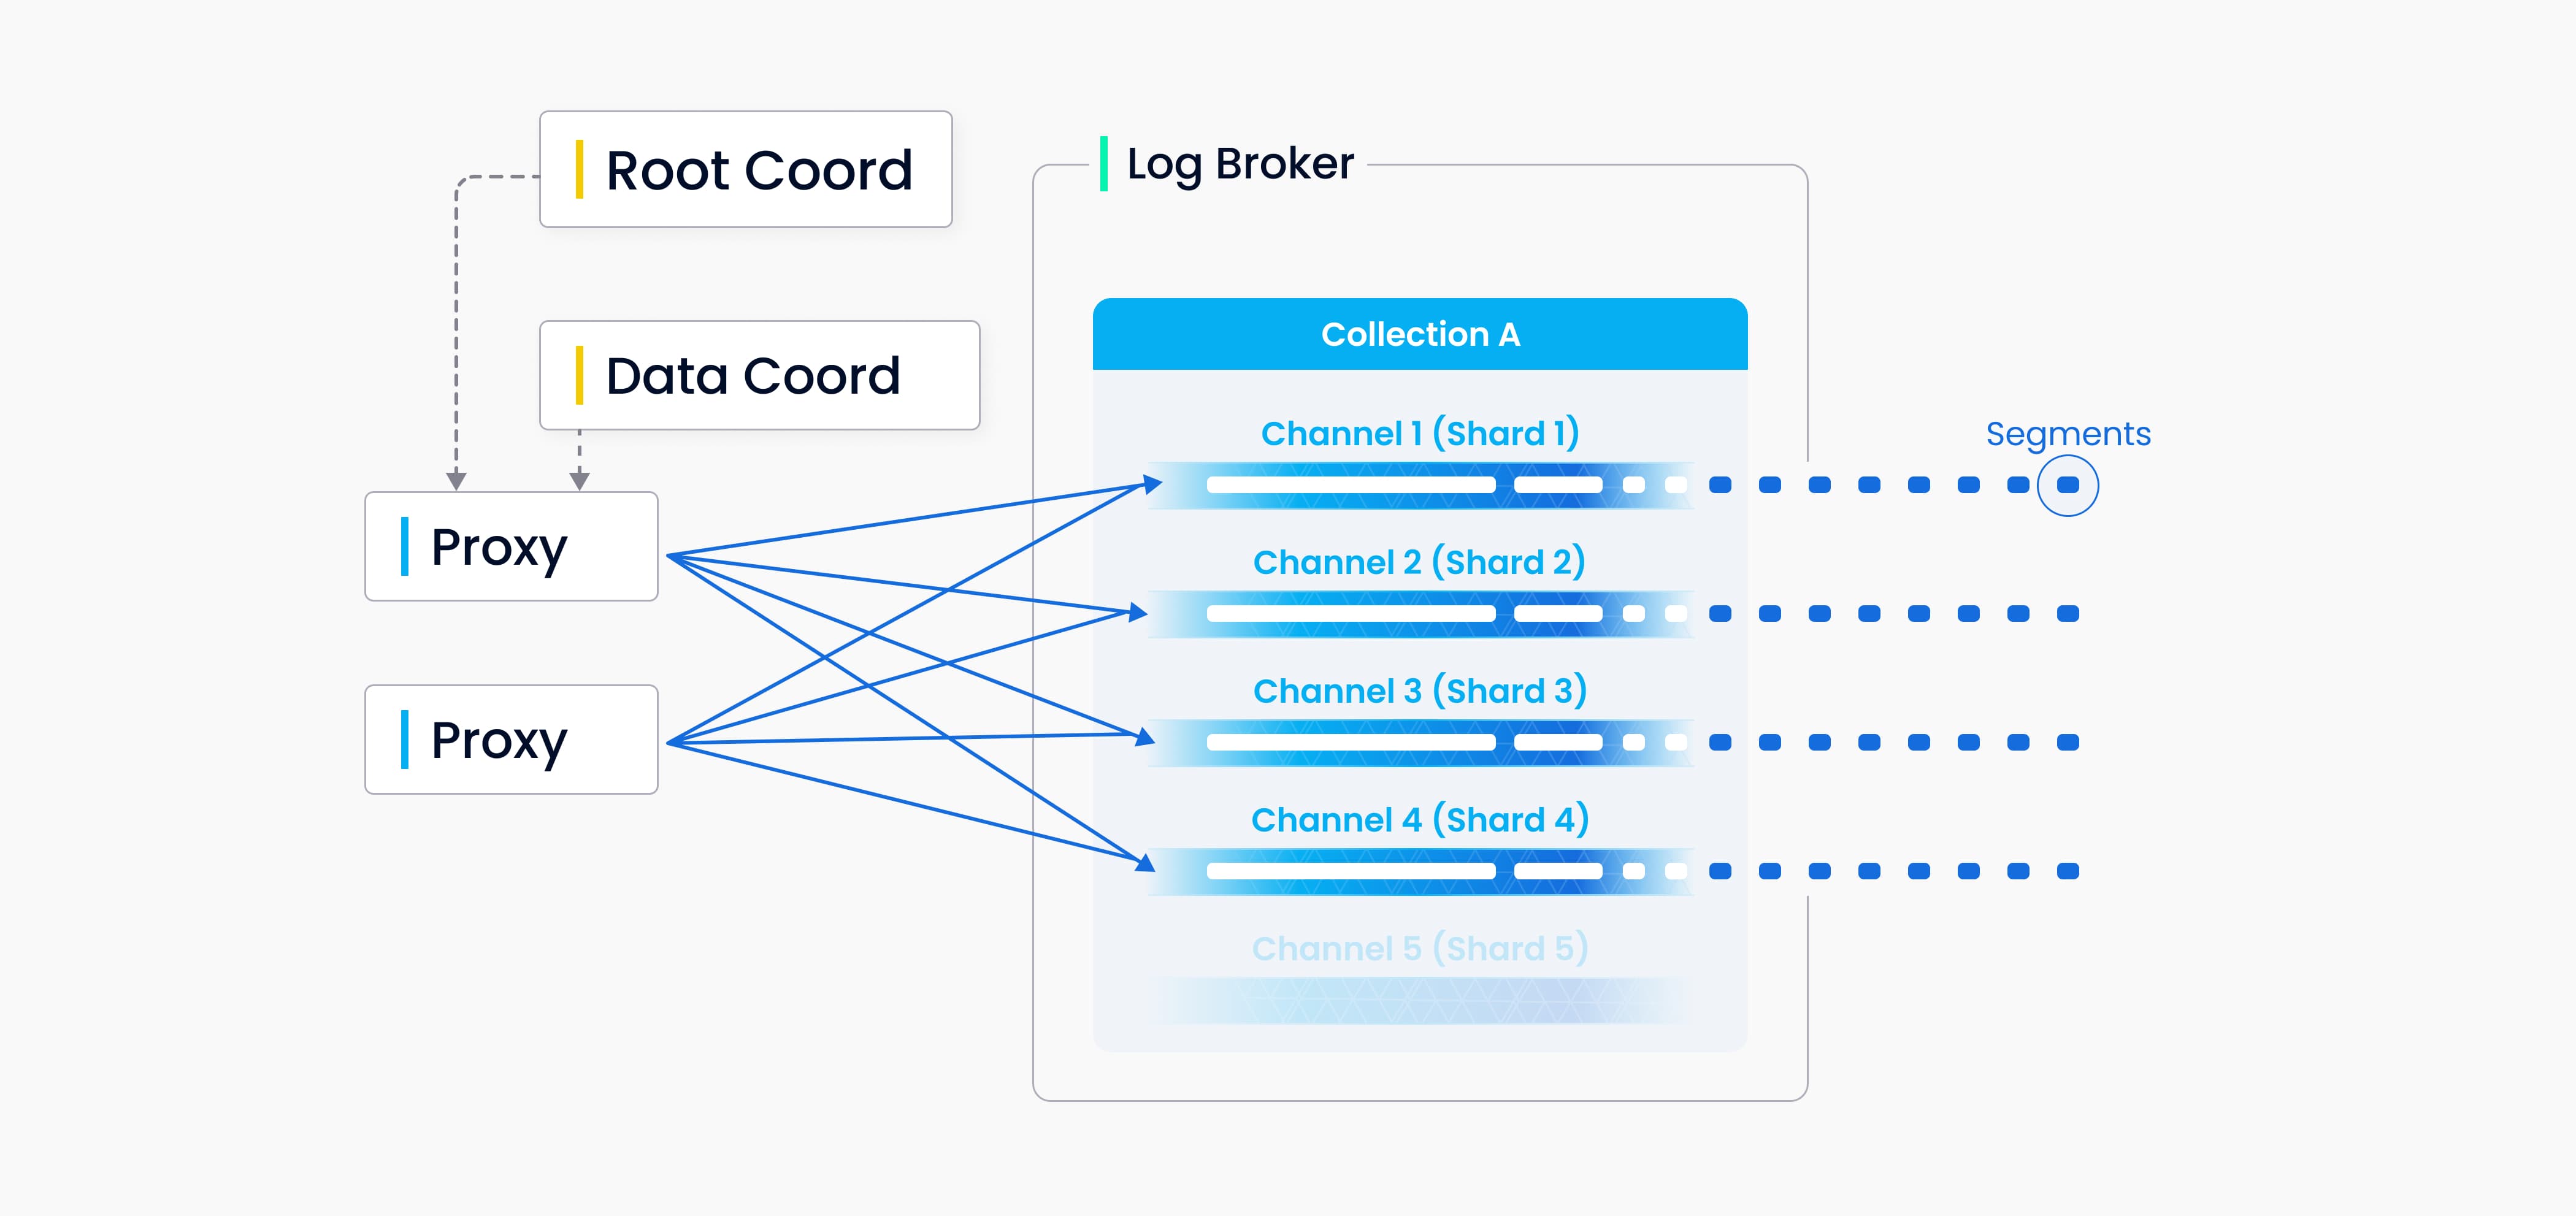
DML(数据操作语言)操作和 DDL(数据定义语言)操作都会写入日志序列,但 DDL 操作由于出现频率较低,因此只分配一个通道。
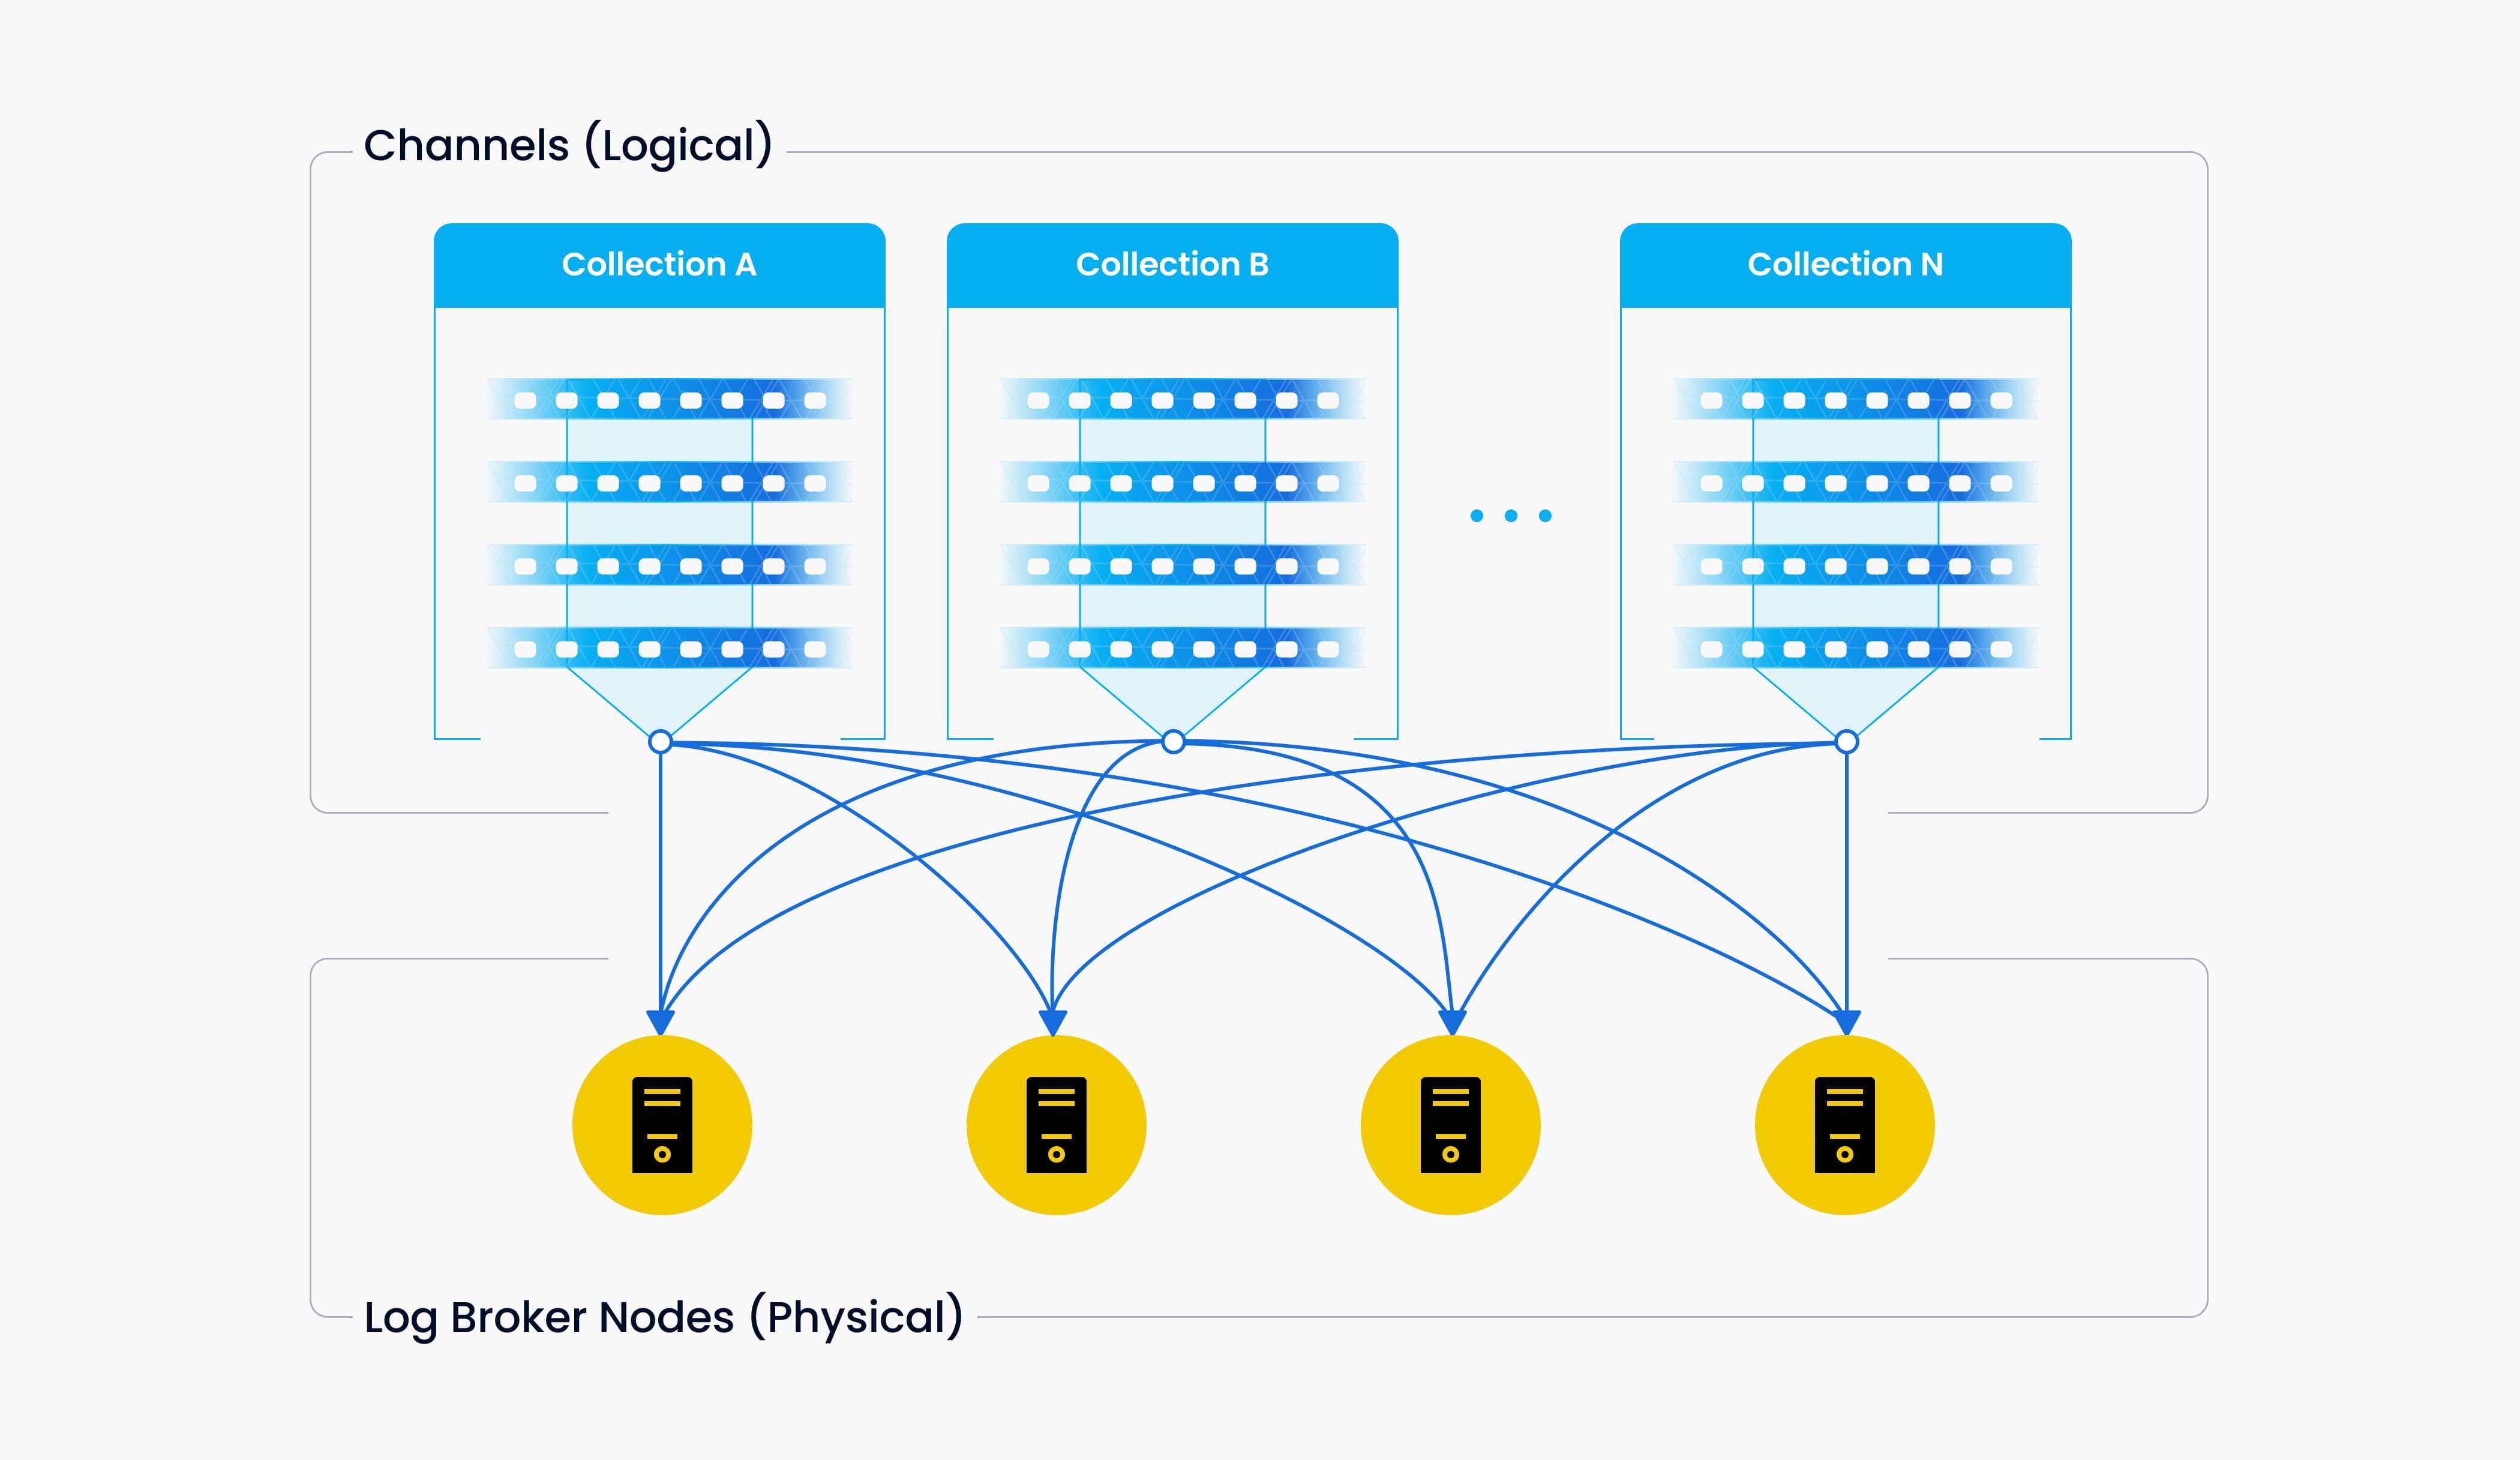
VChannel保存在底层 Log broker 节点中。每个通道在物理上不可分割,可用于任何一个节点。当数据摄取率达到瓶颈时,要考虑两点:Log broker 节点是否超载,是否需要扩展;是否有足够的分片来确保每个节点的负载平衡。
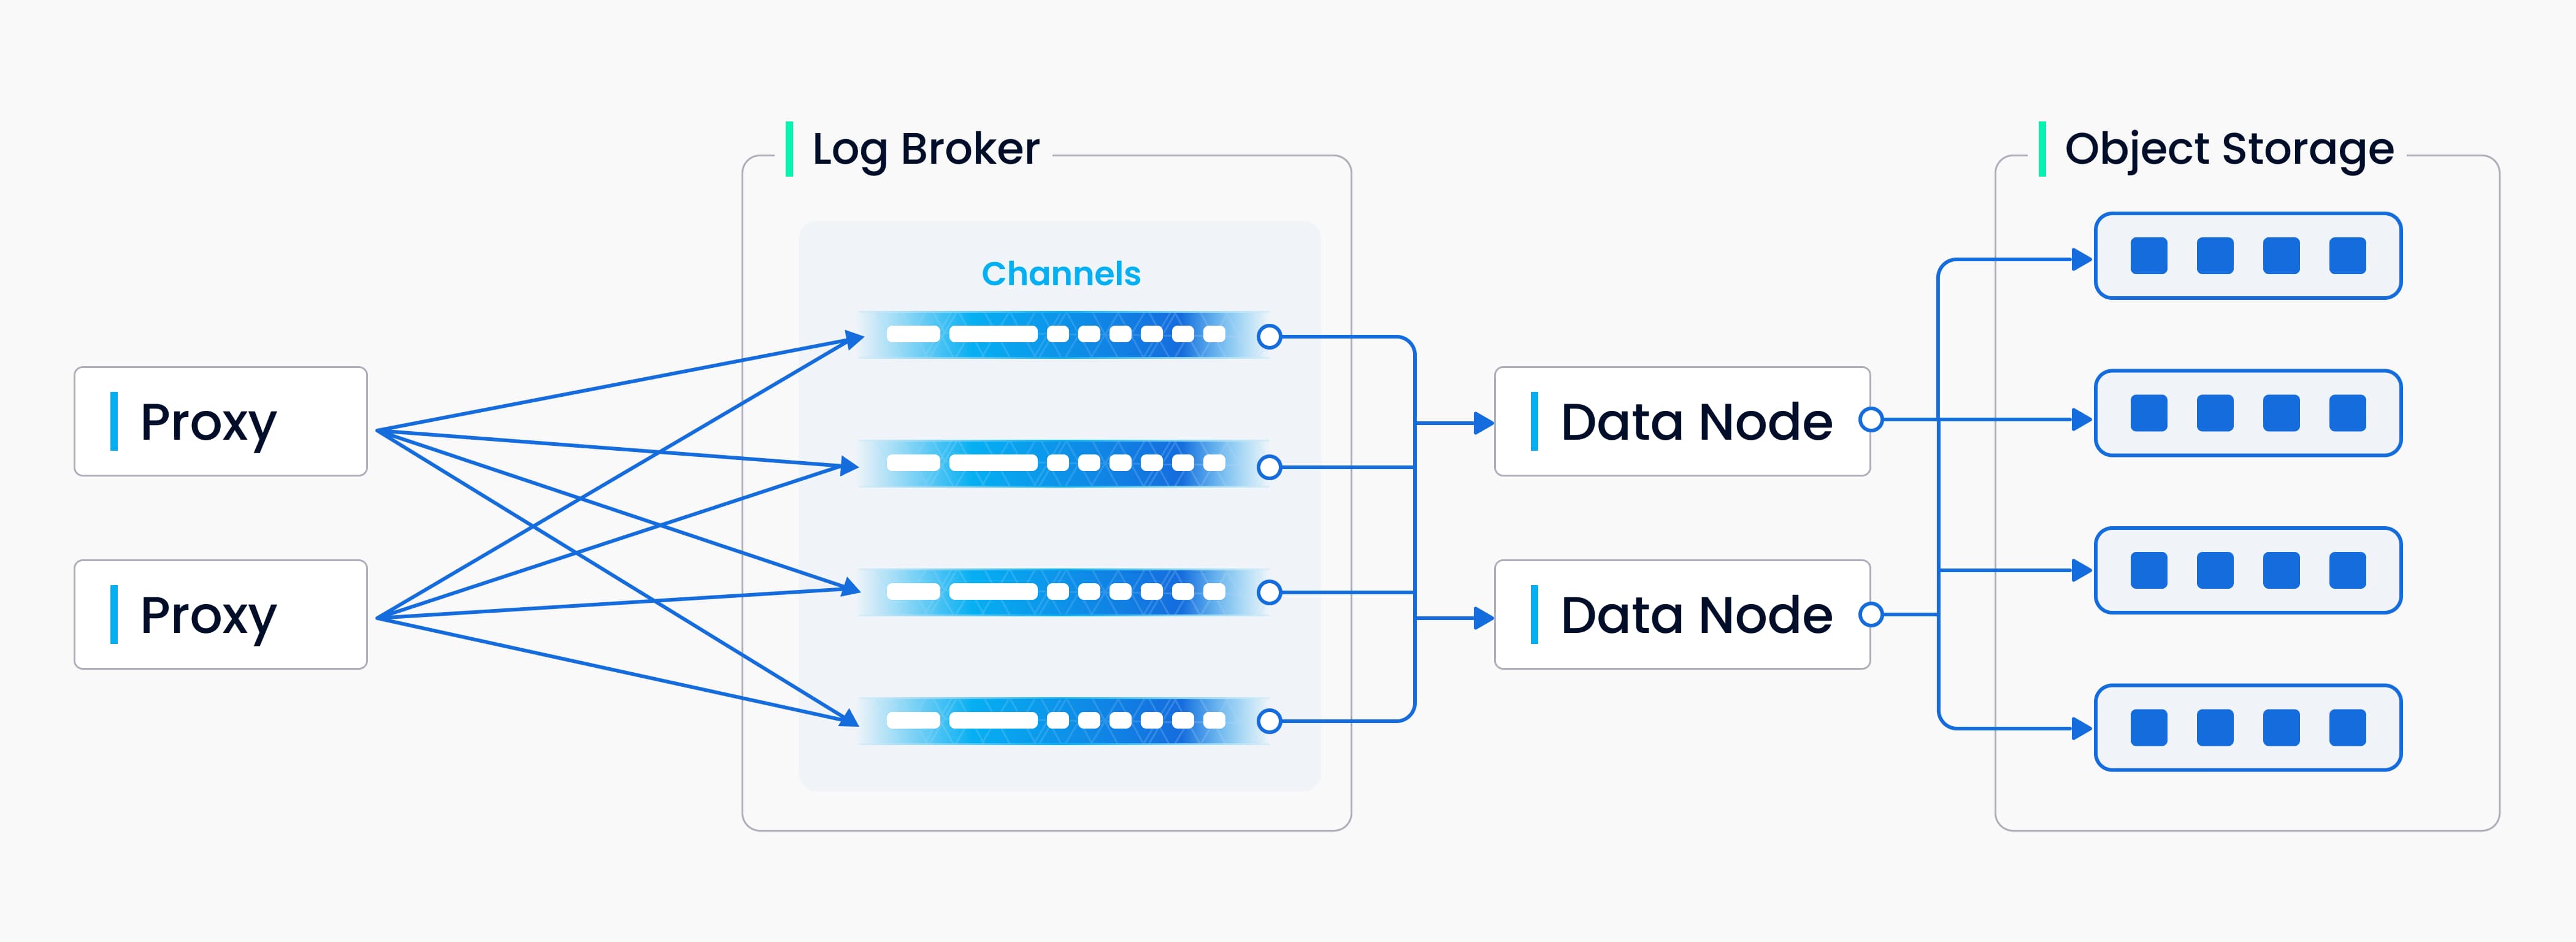
上图封装了写入日志序列过程中涉及的四个组件:Proxy、Log broker、DataNode 和 Object Storage。该流程涉及四项任务:DML 请求的验证、日志序列的发布-订阅、从流日志到 Log snapshot 的转换以及 Log snapshot 的持久化。这四项任务相互解耦,以确保每项任务都由相应的节点类型来处理。同一类型的节点是平等的,可以灵活、独立地扩展,以适应各种数据负载,尤其是海量和高度波动的流数据。
索引构建
索引建立由 IndexNode 执行。为避免数据更新时频繁建立索引,Milvus 将一个 Collection 进一步划分为若干区段,每个区段都有自己的索引。
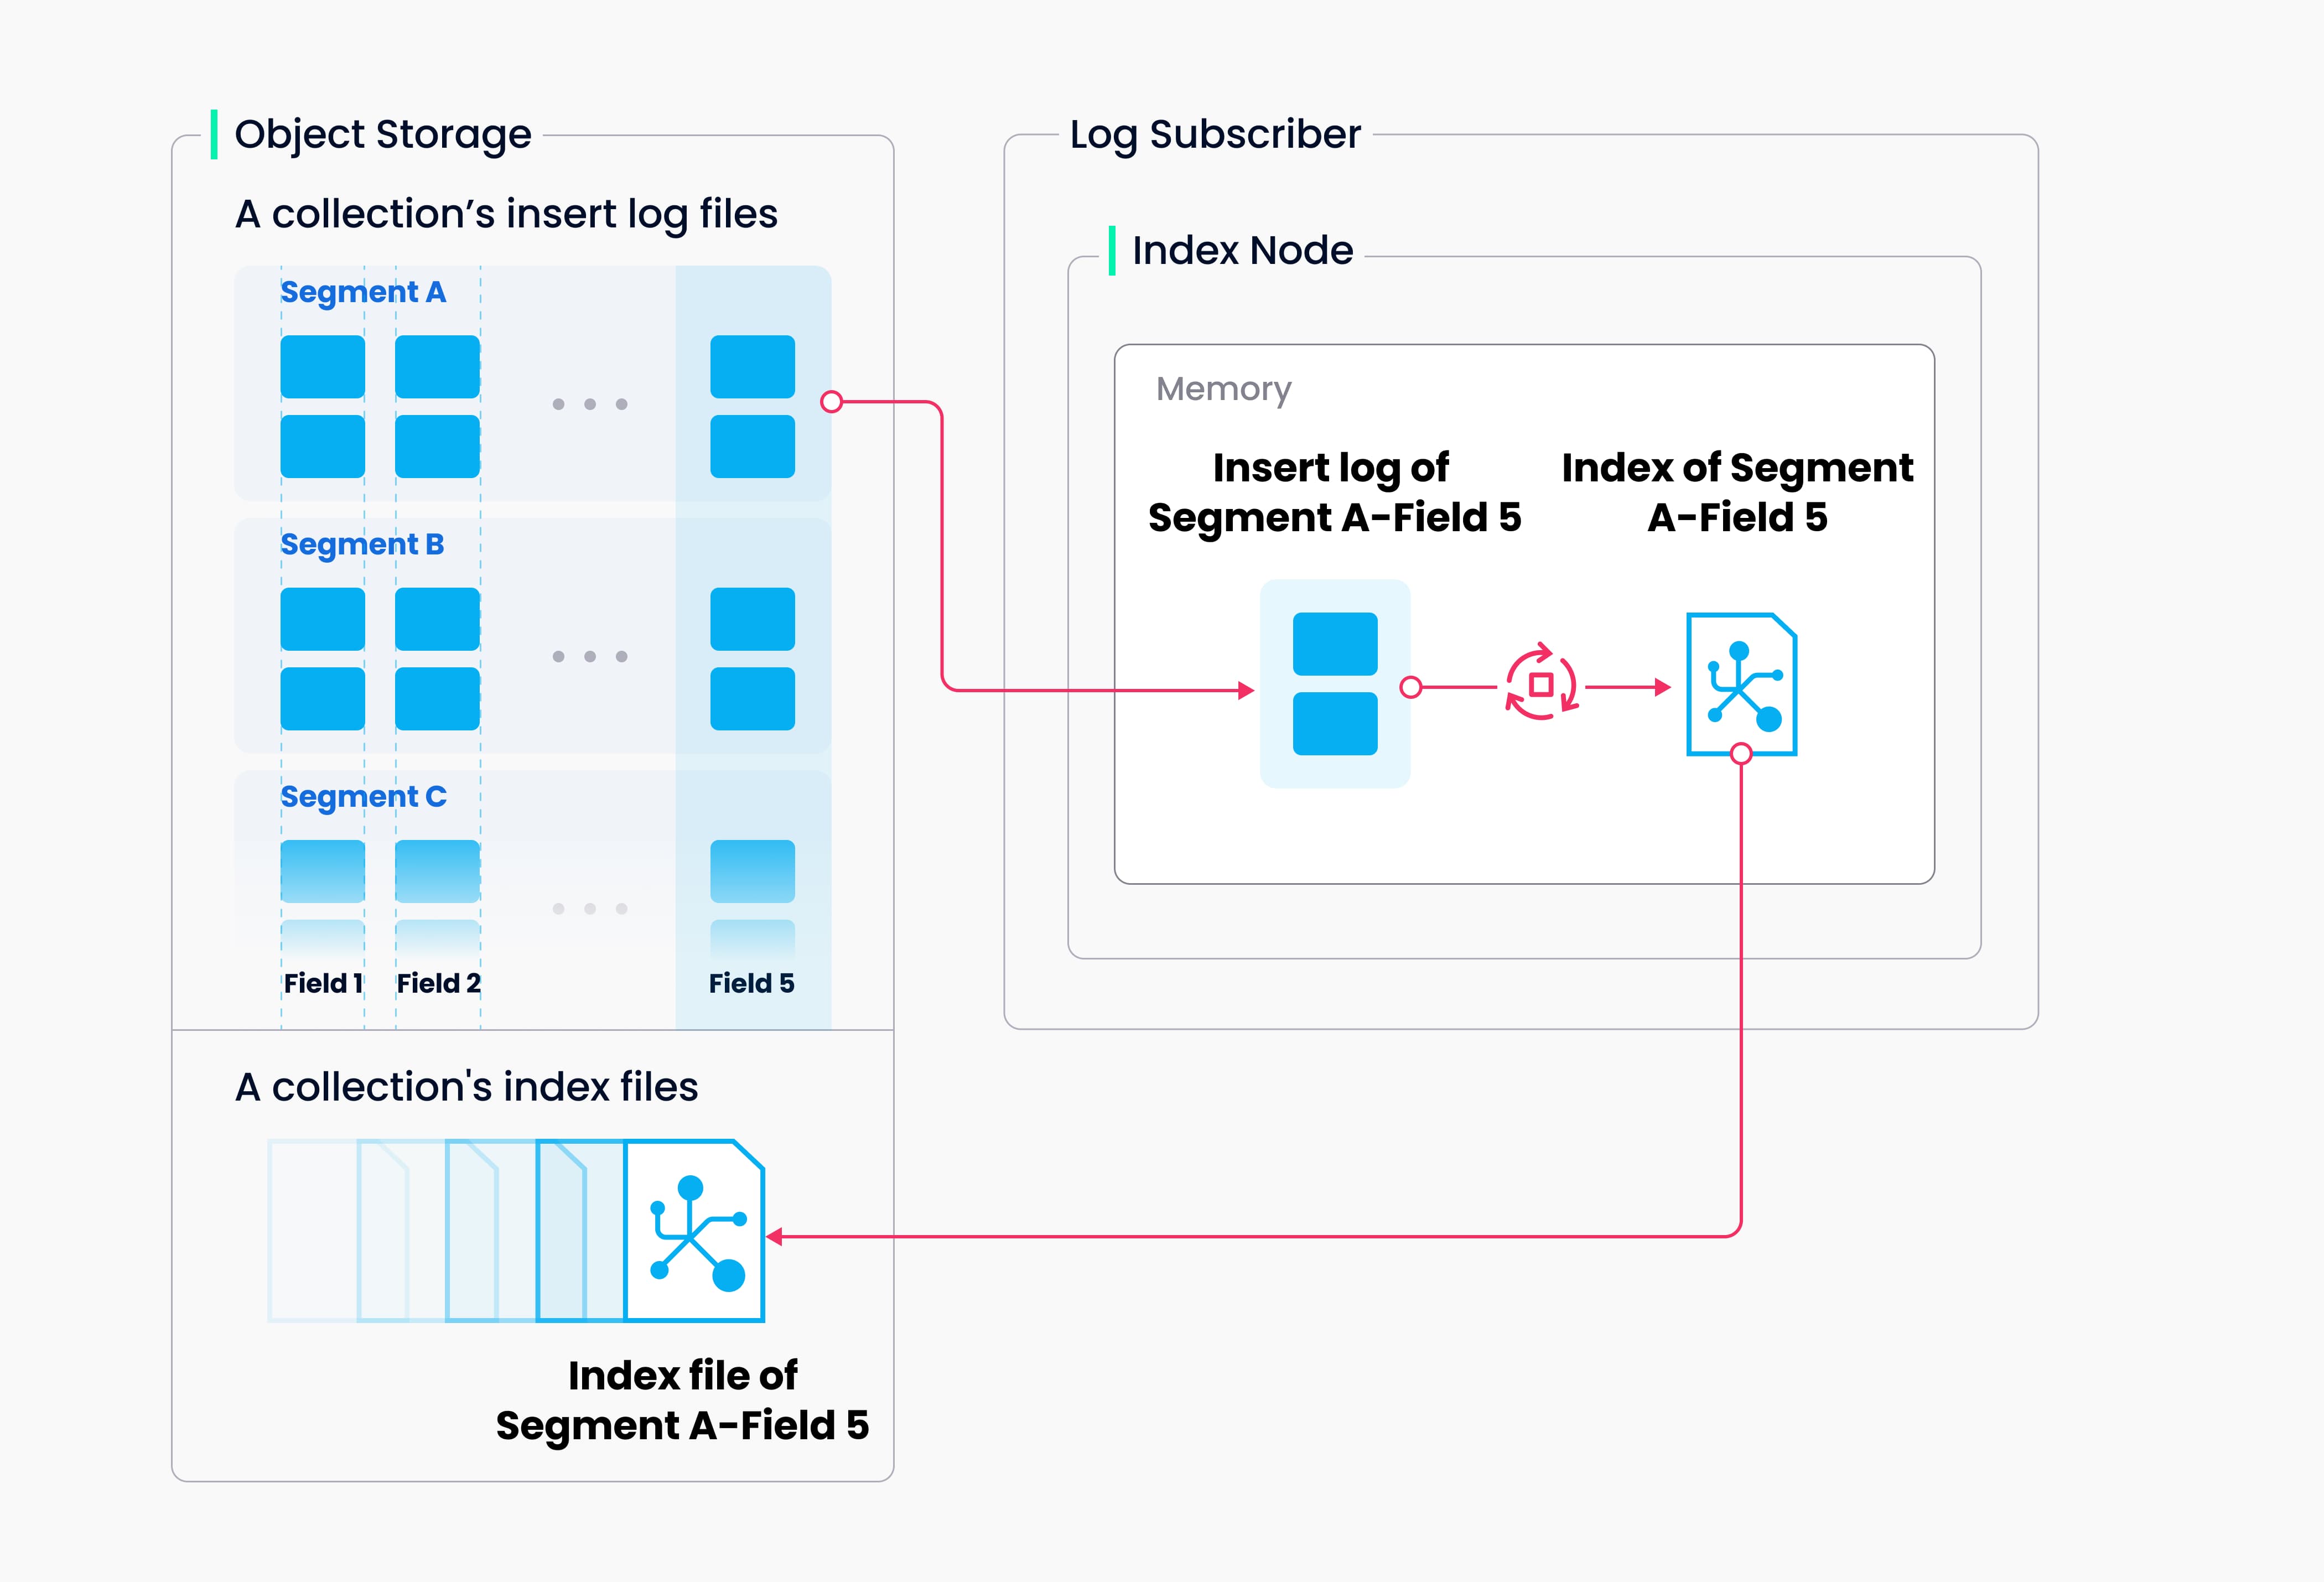
Milvus 支持为向量字段、标量字段和主键字段创建索引。索引构建的输入与输出均存放在 Object Storage 中:DataNode 从 Object Storage 中的 Segment 加载待索引的 Binlog Snapshot,在内存中反序列化数据与元数据并构建索引;构建完成后,再将索引序列化并写回 Object Storage。
索引构建主要涉及向量和矩阵操作,因此是计算和内存密集型操作。向量由于其高维特性,无法使用传统的基于树的索引高效地建立索引,但可以使用专门为此任务设计的技术建立索引,如基于集群或图形的索引。无论其类型如何,建立索引都涉及大规模向量的大量迭代计算,如 K-means 或图遍历。
与标量索引不同,构建向量索引需要充分利用 SIMD(Single Instruction, Multiple Data)加速。Milvus 原生支持 SSE、AVX2 和 AVX512 等 SIMD 指令集。向量索引构建通常具有阶段性突发和高资源消耗的特点,因此弹性伸缩对控制总体成本非常重要。后续版本还会继续探索异构计算和 Serverless 计算,以进一步降低索引构建成本。
Milvus 还支持标量过滤和主键字段查询。它有内置索引来提高查询效率,例如布隆过滤索引、哈希索引、基于树的索引和倒排索引,并计划引入更多外部索引,例如位图索引和粗糙索引。
数据查询
术语 "数据查询 "指的是在指定的 Collection 中搜索距离目标向量最近的k 个向量,或搜索与向量在指定距离范围内的所有向量的过程。向量会连同其相应的主键和字段一起返回。
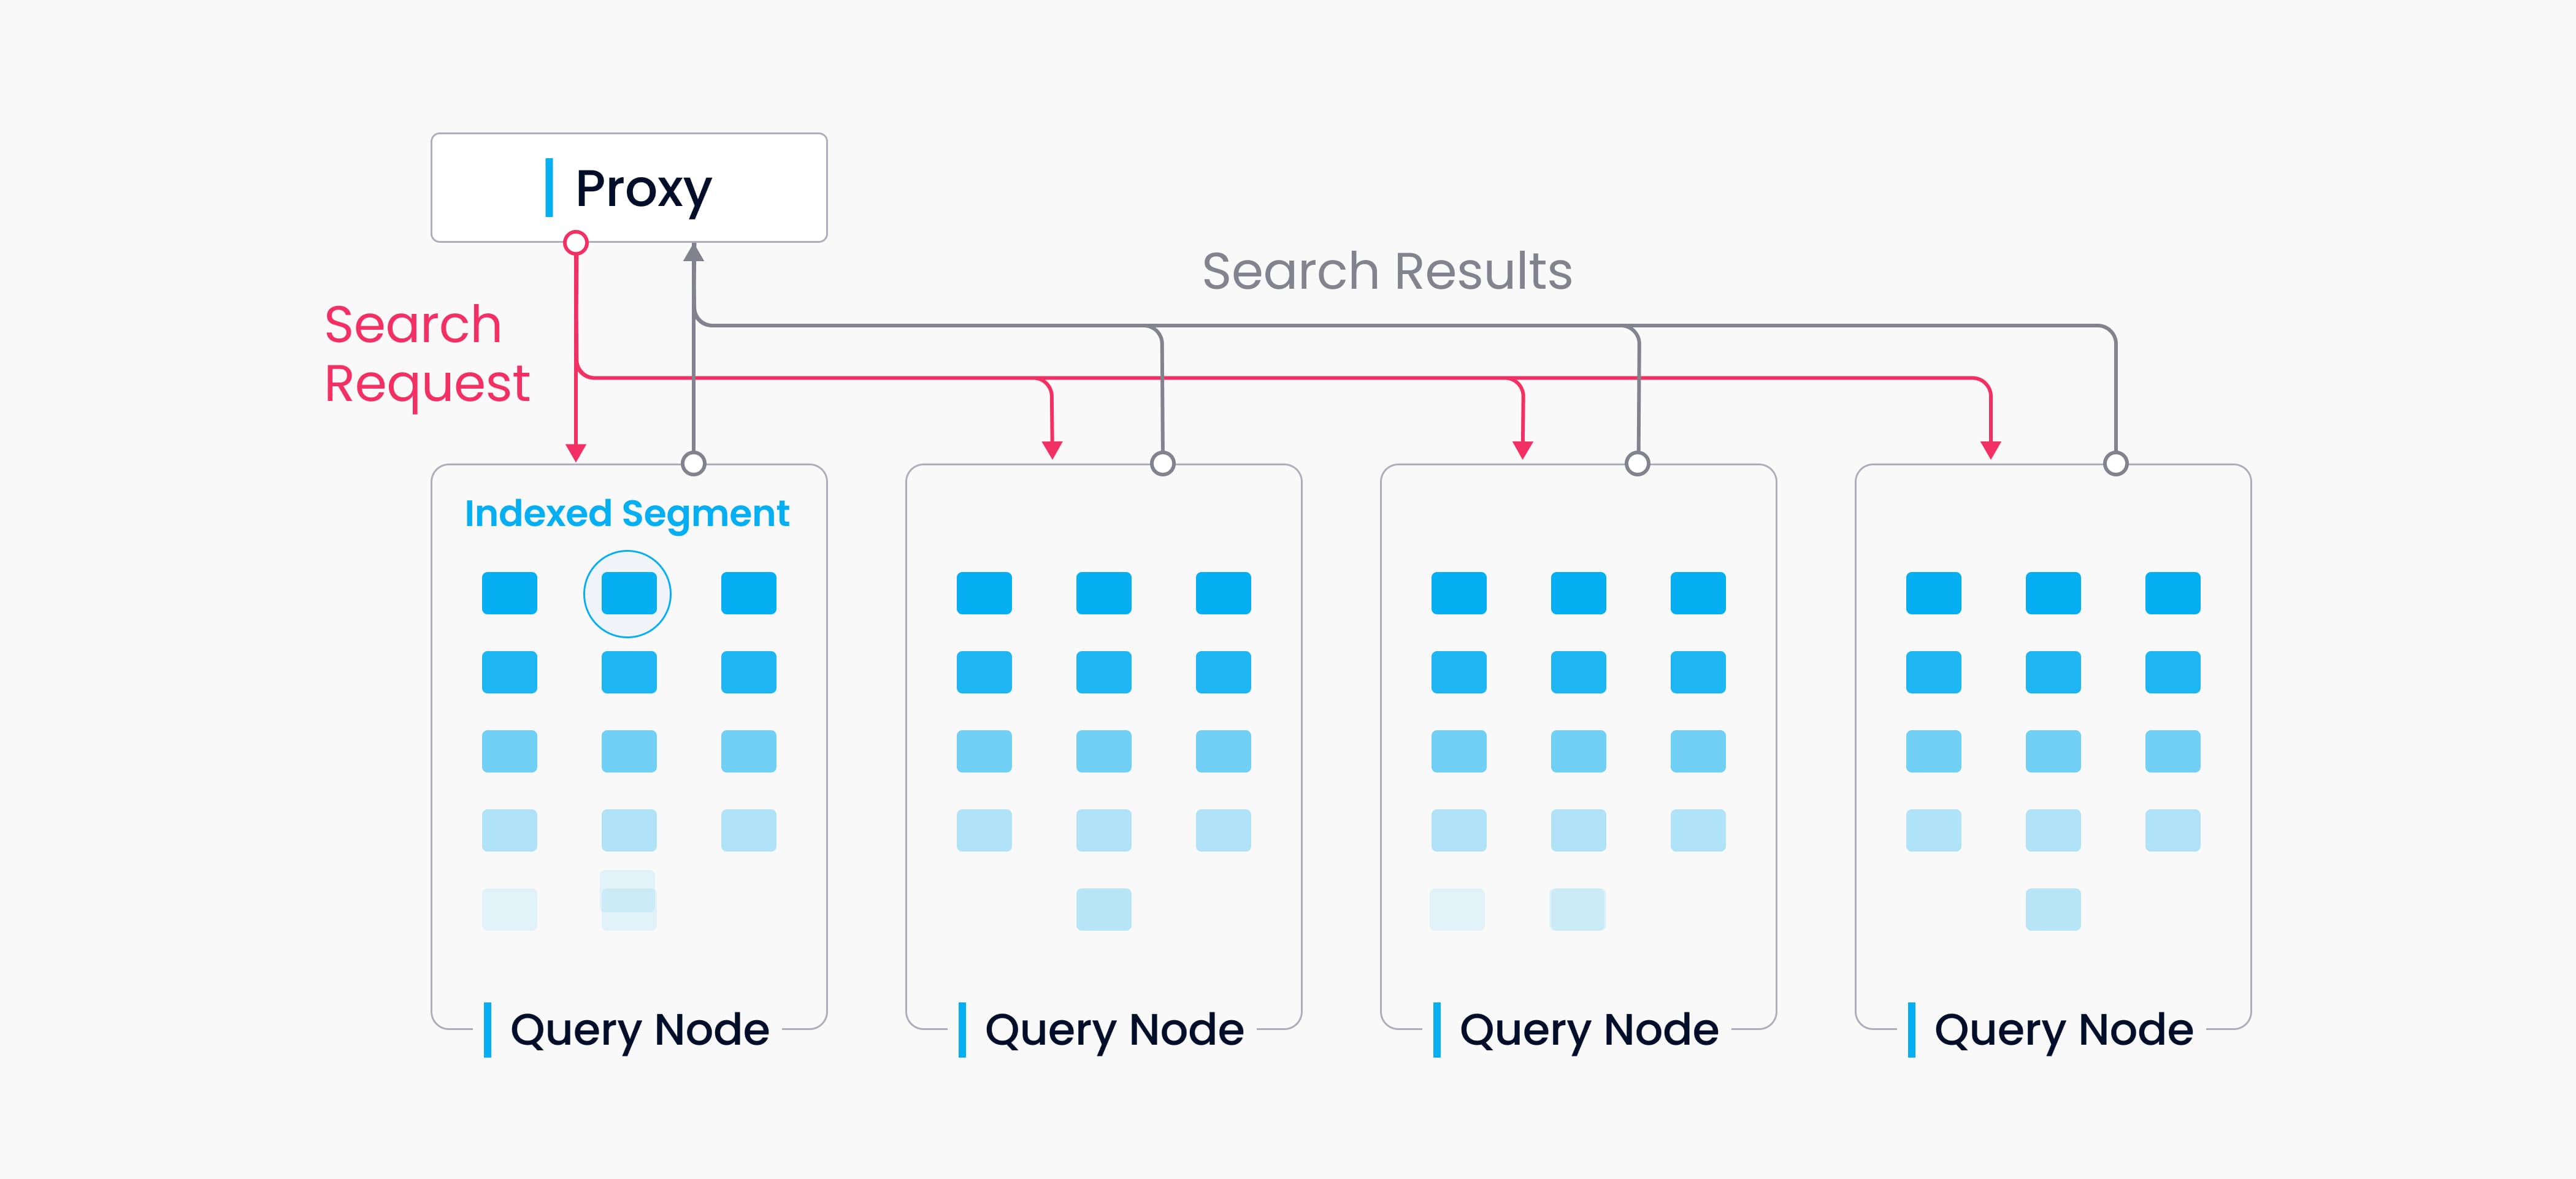
Milvus 中的 Collection 被分割成多个分段,QueryNode 按分段加载索引。当搜索请求到达时,它会广播给所有 QueryNode 进行并发搜索。然后,每个节点都会修剪本地段,搜索符合条件的向量,并还原和返回搜索结果。
在数据查询中,QueryNode 是相互独立的。每个节点只负责两项任务:根据 QueryCoord 的指令加载或释放数据段;在本地数据段内进行搜索。而 Proxy 负责减少每个 QueryNode 的搜索结果,并将最终结果返回给客户端。
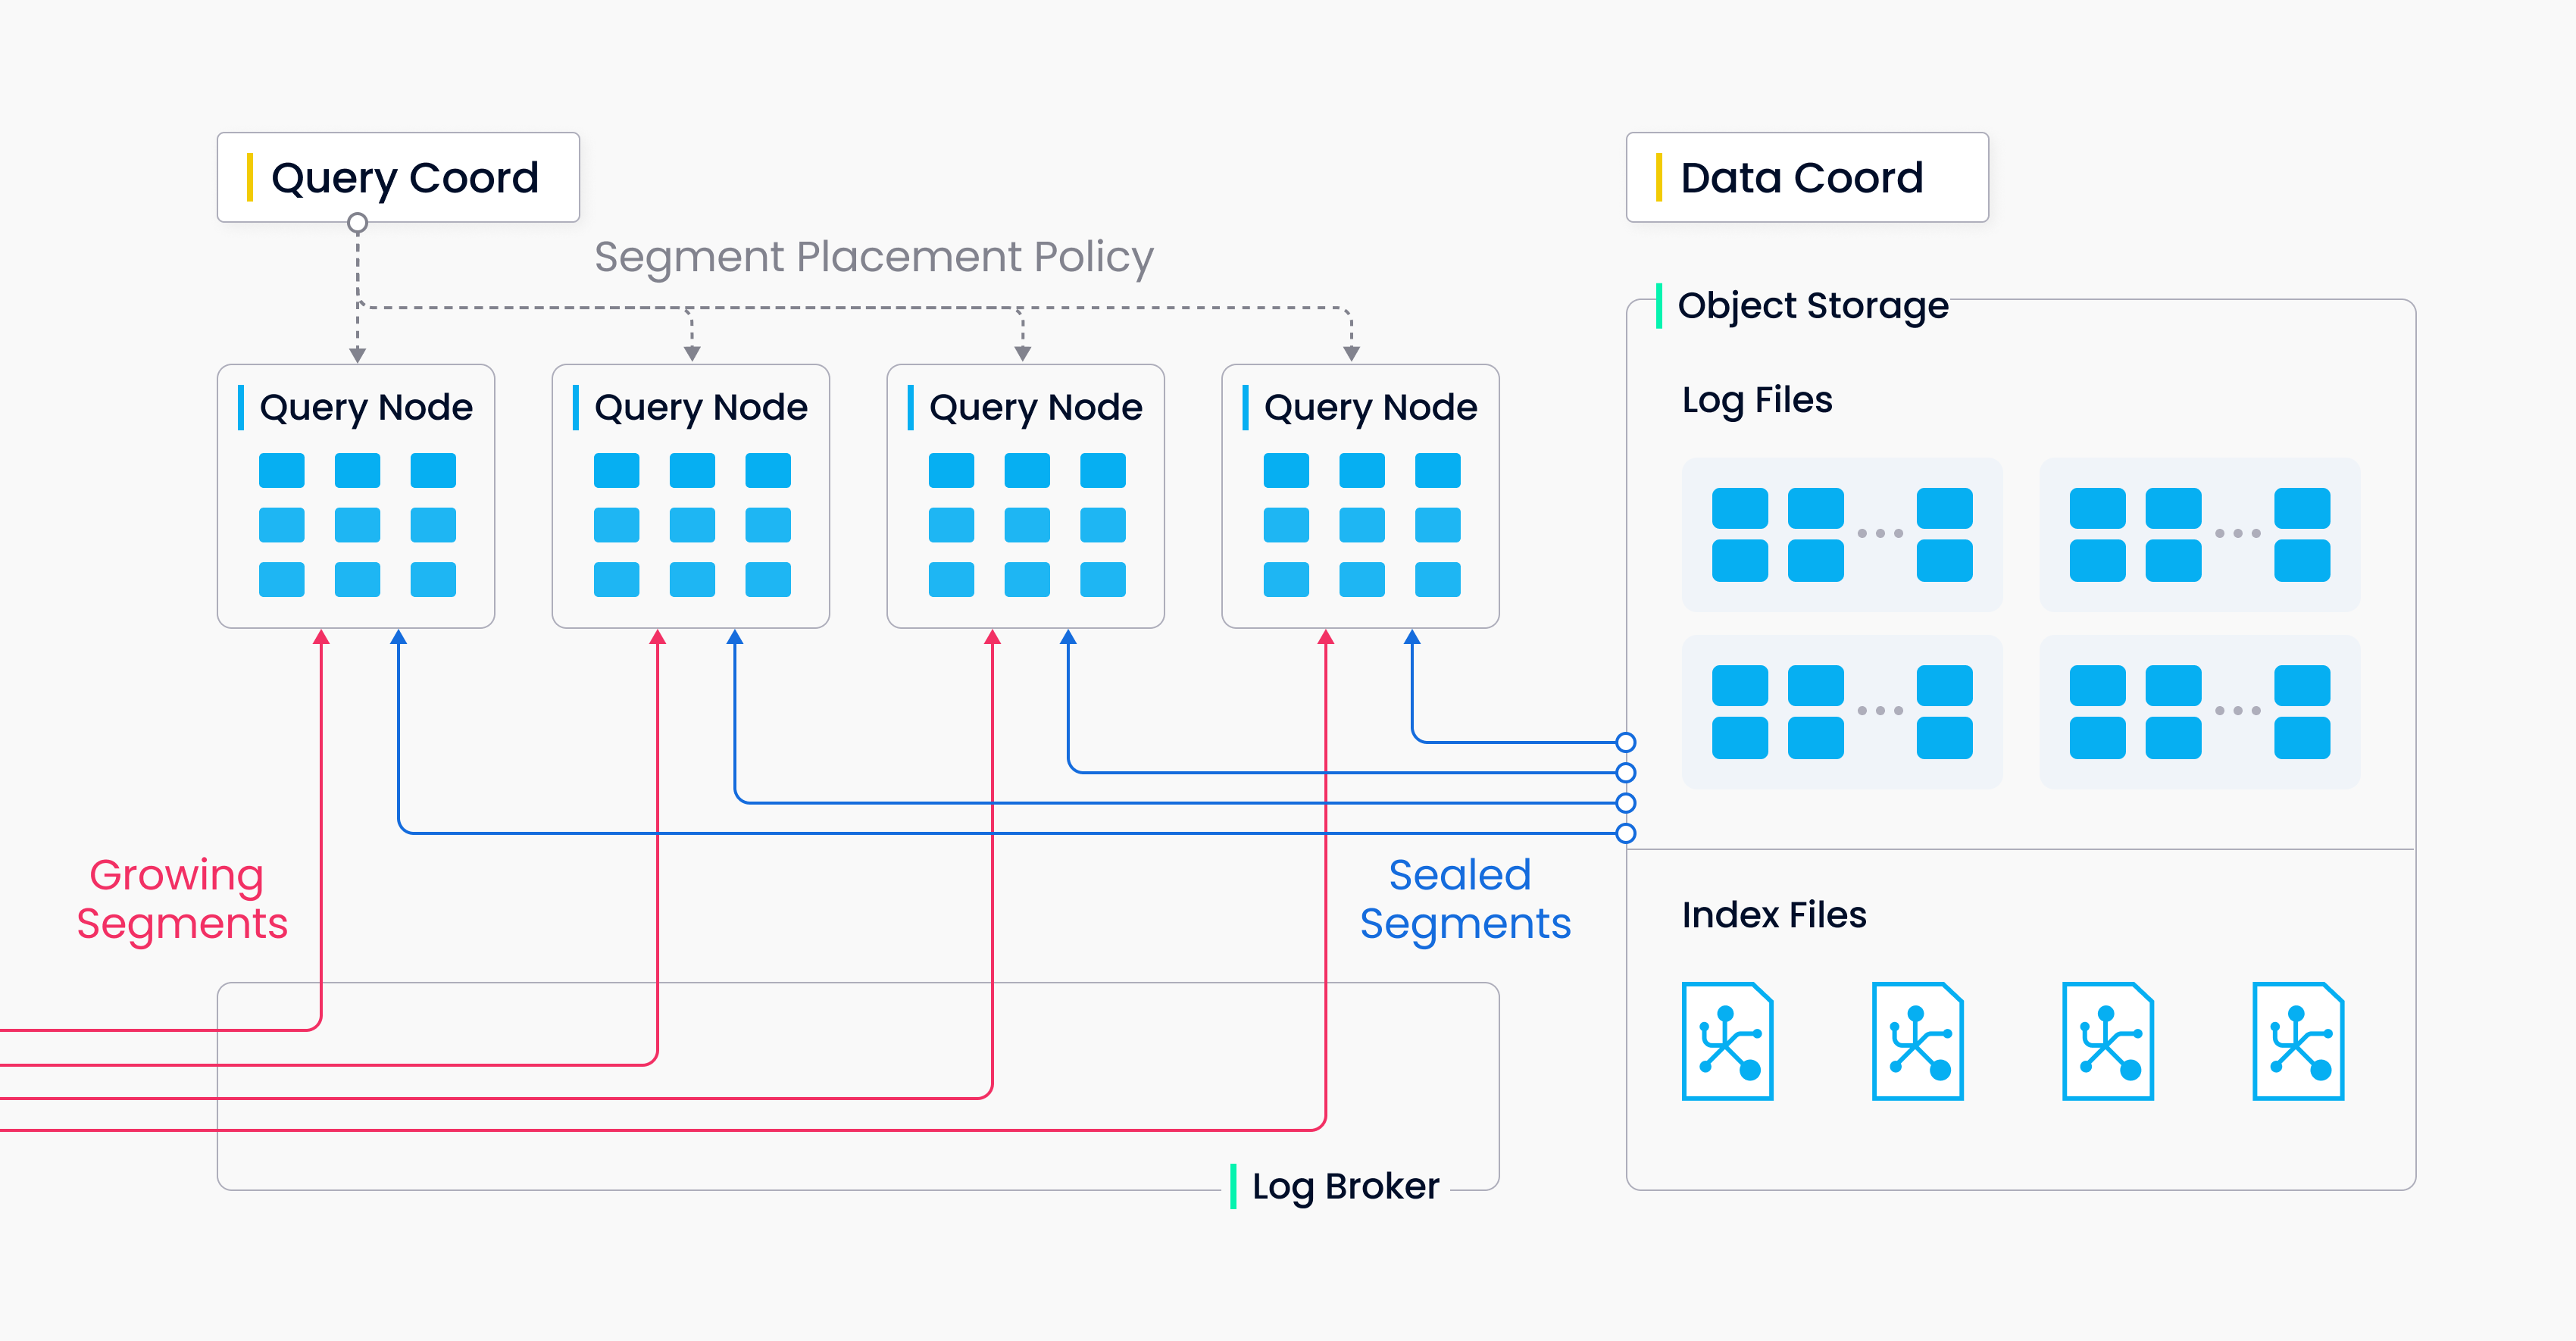
分段有两种,一种是 Growing Segment(用于增量数据),另一种是 Sealed Segment(用于历史数据)。QueryNode 向 vchannel 订阅最新更新(增量数据),作为 Growing Segment。当 Growing Segment 达到预定义阈值时,DataCoord 就会将其封存,并开始建立索引。然后,由 QueryCoord 启动 Handoff 操作,将增量数据转为历史数据。QueryCoord 将根据内存使用情况、CPU 开销和 Segment 数量,在所有 QueryNode 之间平均分配 Sealed Segment。
下一步
- 了解如何 使用 Milvus 向量数据库进行实时查询。
- 了解 Milvus 中的数据插入和数据持久性。
- 了解如何 在 Milvus 中处理数据。