Milvus 架构概述
Milvus 是一个 开源 云原生 向量数据库,专为在海量向量数据集上进行高性能相似性搜索而设计。它建立在流行的向量搜索库(包括 Faiss、HNSW、DiskANN 和 SCANN)之上,可增强人工智能应用和非结构化数据检索场景的能力。在继续之前,请先熟悉一下 Embedding 检索的 基本原理。
架构图
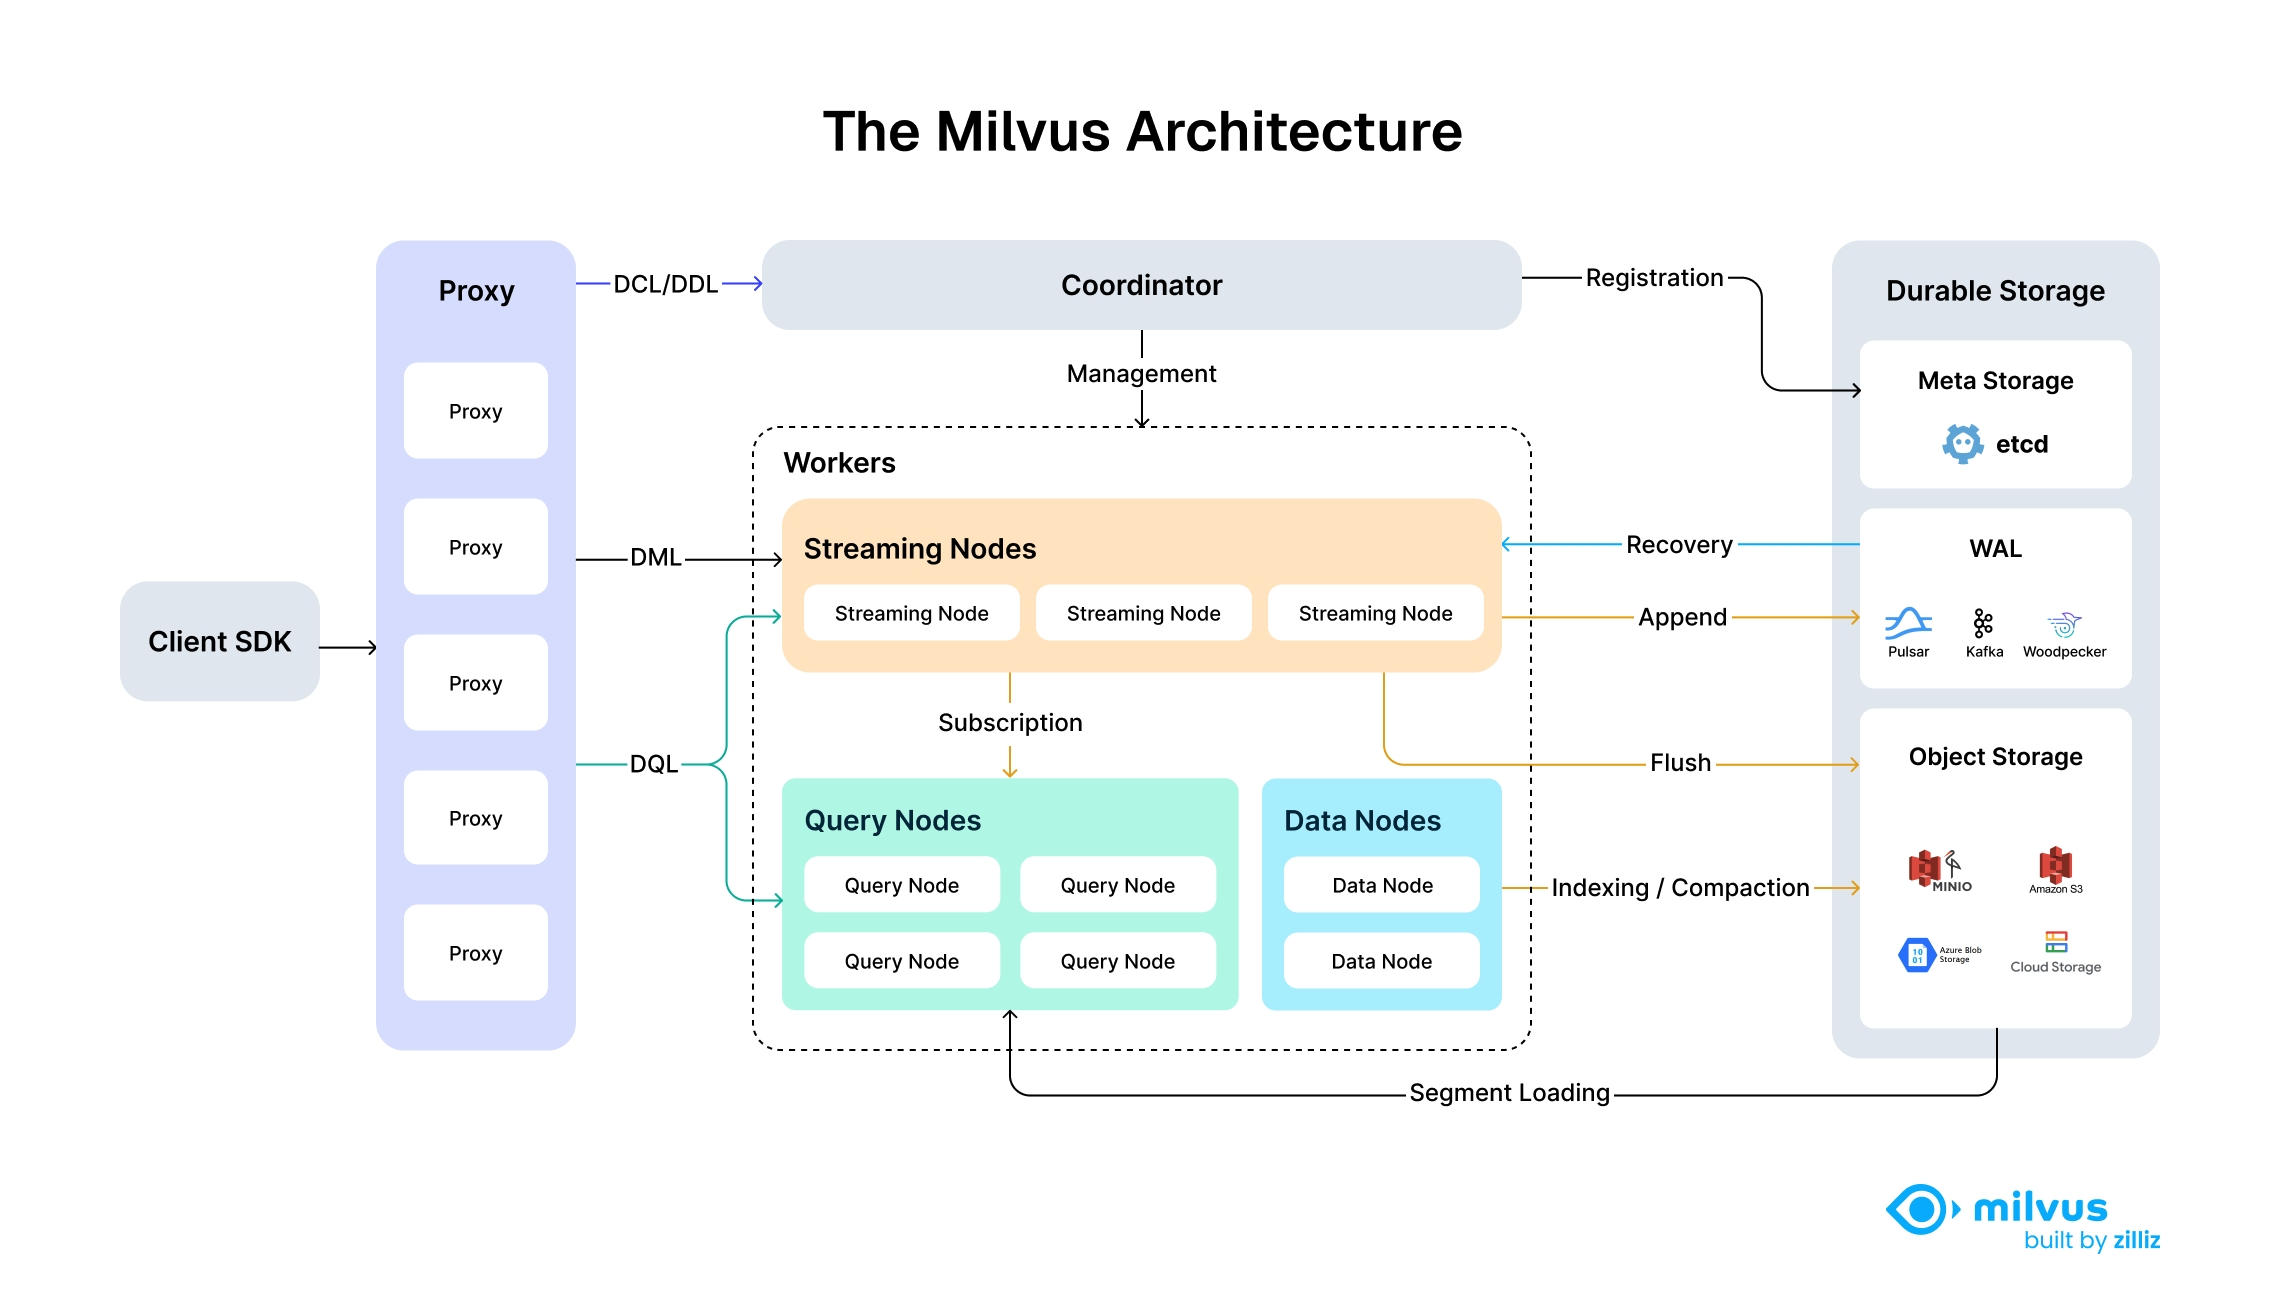
下图说明了 Milvus 的高层架构,展示了其模块化、可扩展和云原生的设计,以及完全分解的存储层和计算层。
架构原则
Milvus 遵循数据平面和控制平面分解的原则,由四个主要层组成,在可扩展性和灾难恢复方面相互独立。这种共享存储架构具有完全分解的存储层和计算层,可实现计算节点的横向扩展,同时将 Woodpecker 作为零磁盘 WAL 层实施,以增强弹性并减少操作开销。
通过将流处理分为 Streaming Node 和批处理分为 QueryNode 和 DataNode,Milvus 在满足实时处理要求的同时实现了高性能。
详细的层架构
第 1 层:Proxy
Proxy 是系统的前端层,由一组无状态节点组成,也是用户的访问入口。它验证客户端请求并减少返回结果:
- Proxy 本身是无状态的。它使用 Nginx、Kubernetes Ingress、NodePort 和 LVS 等负载均衡组件提供统一的服务地址。
- 由于 Milvus 采用的是大规模并行处理(MPP)架构,Proxy 会对中间结果进行聚合和后处理,然后再将最终结果返回给客户端。
第 2 层:Coordinator
Coordinator 是 Milvus 的大脑。在任何时刻,整个集群都有一个 Coordinator 在工作,负责维护集群拓扑结构、调度所有任务类型并保证集群级一致性。
以下是 Coordinator 处理的部分任务:
- DDL/DCL/TSO 管理:处理数据定义语言 (DDL) 和数据控制语言 (DCL) 请求,如创建或删除 Collection、Partition 或索引,以及管理 TSO(时间戳分配服务) 和时间刻度签发。
- 流服务管理:将 WAL(Write-Ahead Log) 与 Streaming Node 绑定,并为流服务提供服务发现功能。
- 查询管理:管理 QueryNode 的拓扑结构和负载平衡,并提供和管理服务查询视图,以指导查询路由。
- 历史数据管理:将 Compaction 和索引建立等离线任务分配给 DataNode,并管理数据段和数据视图的拓扑结构。
第 3 层:工作节点
手臂和腿。工作节点是遵从 Coordinator 指令的执行节点。由于存储和计算分离,工作节点是无状态的,部署在 Kubernetes 上时可促进系统扩展和灾难恢复。工作节点有三种类型:
Streaming Node
Streaming Node 作为分片级的 "小型大脑",基于底层 WAL 存储提供分片级的一致性保证和故障恢复。同时,Streaming Node 还负责增长数据查询和生成查询计划。此外,它还负责将增长数据转换为封存(历史)数据。
QueryNode
QueryNode 从 Object Storage 中加载历史数据,并提供历史数据查询。
DataNode
DataNode 负责离线处理历史数据,如 Compaction 和建立索引。
第 4 层:存储
存储是系统的骨骼,负责数据的持久性。它包括 Meta storage、Log broker 和 Object Storage。
Meta storage
Meta storage 存储元数据快照,如 Collection Schema 和消息消耗检查点。元数据的存储要求极高的可用性、Strong Consistency 和事务支持,因此 Milvus 选择 etcd 作为 Meta storage。Milvus 还使用 etcd 进行服务注册和健康检查。
Object Storage
Object Storage 用于存储 Log snapshot 文件、标量和向量数据的索引文件以及中间查询结果。Milvus 使用 MinIO 作为 Object Storage,可随时部署在 AWS S3 和 Azure Blob 这两个全球最流行、最具成本效益的存储服务上。然而,Object Storage 的访问延迟较高,并按查询次数收费。为了提高性能并降低成本,Milvus 计划在基于内存或固态硬盘的缓存池上实现冷热数据分离。
WAL 存储
WAL(Write-Ahead Log) 存储是分布式系统中数据持久性和一致性的基础。在提交任何更改之前,首先要将其记录在日志中,以确保在发生故障时,可以准确恢复到之前的位置。
常见的 WAL 实现包括 Kafka、Pulsar 和 Woodpecker。与传统的基于磁盘的解决方案不同,Woodpecker 采用云原生的零磁盘设计,直接写入 Object Storage。这种方法可以毫不费力地根据您的需求进行扩展,并通过消除管理本地磁盘的开销来简化运维。
通过提前记录每次写入操作,WAL 层保证了可靠的全系统恢复和一致性机制--无论你的分布式环境发展得多么复杂。
数据流和 API 类别
Milvus API 按其功能分类,并遵循架构的特定路径:
| API 类别 | 操作类型 | 示例 API | 架构流程 |
|---|---|---|---|
| DDL/DCL | Schema 和访问控制 | createCollection,dropCollection,hasCollection、createPartition | Proxy → Coordinator |
| DML | 数据操作 | insert,delete、upsert | Proxy → Streaming Node |
| DQL | 数据查询 | search,query | Proxy → 批量工作节点(QueryNode) |
数据流示例:搜索操作
- 客户端通过 SDK/RESTful API 发送搜索请求
- 负载平衡器将请求路由到可用的 Proxy
- Proxy 使用路由缓存确定目标节点;只有在缓存不可用时才联系 Coordinator
- Proxy 将请求转发到适当的 Streaming Node,然后与 QueryNode 协调进行密封数据搜索,同时在本地执行增长数据搜索
- QueryNode 根据需要从 Object Storage 中加载 Sealed Segment,并执行分段级搜索
- 对搜索结果进行多级缩减:QueryNode 还原多个分段的结果,Streaming Node 还原 QueryNode 的结果,Proxy 还原所有 Streaming Node 的结果,然后返回客户端
数据流示例:数据插入
- 客户端发送带有向量数据的插入请求
- Proxy 验证请求并转发给 Streaming Node
- Streaming Node 将操作记录到 WAL 存储,以确保持久性
- 实时处理数据并提供查询
- 当分段达到容量时,Streaming Node 触发转换为 Sealed Segment
- DataNode 处理 Compaction,并在 Sealed Segment 上建立索引,将结果存储在 Object Storage 中
- QueryNode 加载新建索引并替换相应的增长数据