实战|CLIP+Milvus,多模态embedding 如何用于以文搜图

为了在朋友圈优雅地假装文艺青年,之前,我用向量数据库Milvus开发了应用语义搜索古诗词,它可以把白话文“变成”古诗词(详见朋友圈装腔指南:如何用向量数据库把大白话变成古诗词)。
但是,在朋友圈只发文字未免单调了些,还是需要搭配与古诗词意境相似的图片才行。但是,直接用古诗词检索图片,效果不太理想。
那么,可以通过向量数据库检索和古诗词含义相近的图片吗?
答案是当然可以,实现方法和文本的语义检索相似,只不过这次我们要使用多模态的embedding模型。
而且,这一套方法,不只能用于古诗文配图,其实也是多数场景(如电商搜索、自动驾驶长尾场景搜寻等)里我们做文生图、自然语言检索图片的基础操作。
本文将对如何实现这一系统给出保姆级教程。
01 多模态embedding模型是如何工作的
纯文本的embedding模型可以根据文本生成向量,语义相近的文本生成的向量,在向量空间的距离相近,而从实现语义检索。如果我想使用文本检索图,比如,用“狗”这个字检索狗的图片,这就需要用到多模态embedding模型。
如果我们直接把文本向量和图片向量映射到同一个向量空间中,会发现相近概念的向量距离往往并不靠近,所以无法直接比较。而CLIP(Contrastive Language-Image Pre-training) 等embedding模型通过训练,能够让模态(比如文本和图片)不同,但是概念相近的向量,距离也相近。这样,就可以通过文本检索概念相近的图片了。
那么,CLIP是怎么训练的呢?主要包括以下4个步骤。
第1步,准备数据集。训练模型需要使用图文配对的多模态数据集。
第2步,编码文本和图片。分别使用文本编码器和图片编码器对文本和图片编码,得到它们的向量。
第3步,把文本和图片映射到同一空间。将文本和图片的向量从各自的单模态向量空间投射到同一个多模态向量空间中。换句话说,就是embedding模型根据文本和图片生成相同维度的向量,然后放入同一个向量空间。
第4步,训练模型。数据集的结构如下图所示,文本向量和图片向量分布在矩阵的横轴和纵轴上,而且对角线上的文本和图片概念相近。
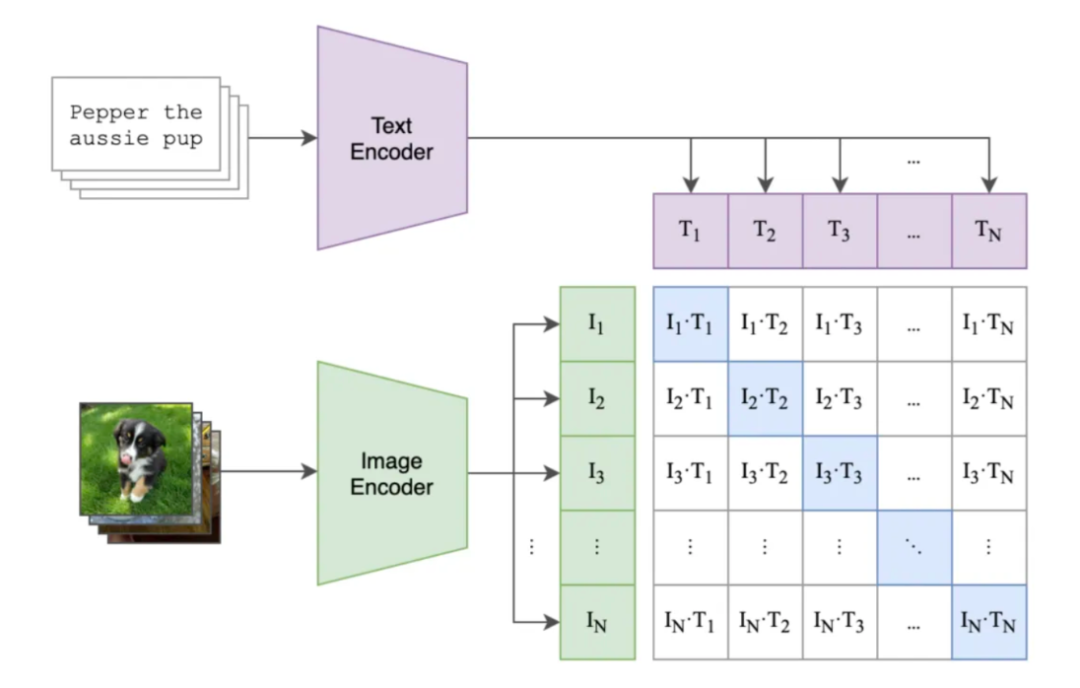
图片来源:Learning Transferable Visual Models From Natural Language Supervision
刚开始,概念相近的文本和图片在向量空间中的距离往往比较远,训练模型的方法,就是拉近概念相近的文本和图片(正样本)的距离,同时推远不同概念(负样本)的距离。
比如,拉近文本“狗”和狗的图片的距离,而推远“鸟”这个概念(包括文本、图片等)与“狗”的距离。通过这一推一拉,最终让概念相近的文本和图片的向量,在同一个向量空间中越来越靠近。这种使用正反例的训练方法叫做对比学习(contrastive learning)。
原理了解了,下面我们就来用代码实践一下吧。
02 手把手实践
(1)准备工作
首先安装Milvus和pymilvus包,这里不再赘述,版本建议:Milvus 版本>=2.5.0,pymilvus 版本>=2.5.0。
然后安装CLIP的中文微调版Chinese-CLIP。
安装方法1:通过pip安装。
pip install cn_clip
安装方法2:下载Chinese-CLIP,从源代码安装。
cd Chinese-CLIP
!pip install -e .
最后下载Landscapes HQ dataset数据集。LHQ1024_jpg共有90000张图片,为了方便演示,文本只使用了前5000张。在这里下载,提取码: 7d88。
下载后解压,里面有图片query_image.jpg和文件夹lhq_1024_jpg_5000,这是后面需要用到的图片数据集。还有一个文件夹chinese_clip_model,里面放的是后面要用到的多模态embedding模型clip_cn_vit-b-16.pt,这是为了避免因为网络问题无法下载,所以提前准备了。
(2)创建集合
首先创建模式,需要3个字段,id表示图片的唯一标识符,vectors表示图片的向量,filepath则是图片的路径。
# 创建模式
from pymilvus import MilvusClient, DataType
import torch
import time
milvus_client = MilvusClient(uri="http://localhost:19530")
def create_schema():
    schema = milvus_client.create_schema(
        auto_id=True,
        enable_dynamic_field=True,
        description=""
    )
    schema.add_field(field_name="id", datatype=DataType.INT64, descrition='ids', is_primary=True)
    schema.add_field(field_name="vectors", datatype=DataType.FLOAT_VECTOR, descrition='embedding vectors', dim=512)
    schema.add_field(field_name="filepath", datatype=DataType.VARCHAR, descrition='file path', max_length=200)
    return schema
schema = create_schema()
接下来定义一个创建集合的函数。
# 定义创建集合的函数
import time
def create_collection(collection_name, schema, timeout = 3):
    # 创建集合
    try:
        milvus_client.create_collection(
            collection_name=collection_name,
            schema=schema,
            shards_num=2
        )
        print(f"开始创建集合:{collection_name}")
    except Exception as e:
        print(f"创建集合的过程中出现了错误: {e}")
        return False
    # 检查集合是否创建成功
    start_time = time.time()
    while True:
        if milvus_client.has_collection(collection_name):
            print(f"集合 {collection_name} 创建成功")
            return True
        elif time.time() - start_time > timeout:
            print(f"创建集合 {collection_name} 超时")
            return False
        time.sleep(1)
为了避免集合重名导致冲突,创建集合前先删除同名集合。
# 定义检查并且删除同名集合的函数
class CollectionDeletionError(Exception):
    """删除集合失败"""
def check_and_drop_collection(collection_name):
    if milvus_client.has_collection(collection_name):
        print(f"集合 {collection_name} 已经存在")
        try:
            milvus_client.drop_collection(collection_name)
            print(f"删除集合:{collection_name}")
            return True
        except Exception as e:
            print(f"删除集合时出现错误: {e}")
            return False
    return True
创建集合。
collection_name = "multimodal_chinese_clip"
uri="http://localhost:19530"
milvus_client = MilvusClient(uri=uri)
# 如果无法删除集合,抛出异常
if not check_and_drop_collection(collection_name):
    raise CollectionDeletionError('删除集合失败')
else:
    # 创建集合的模式
    schema = create_schema()
    # 创建集合并等待成功
    create_collection(collection_name, schema)
(3)定义向量化函数
集合创建完成后,接下来就是把数据集中的图片向量化,插入Milvus。向量化需要使用embedding模型,Chinese-CLIP包含多个embedding模型,查看方法如下:
import cn_clip.clip as clip
# 导入可用模型的函数
from cn_clip.clip import available_models
import torch
# 用于图片处理
from PIL import Image
# 查看 chinese-clip 中可用模型列表
print("Available models:", available_models())
输出:
Available models: ['ViT-B-16', 'ViT-L-14', 'ViT-L-14-336', 'ViT-H-14', 'RN50']
Chinese-CLIP的embedding模型分成ViT(Vision Transformer)架构和RN(ResNet)架构两种。
先介绍ViT系列模型,它的命名规律是,ViT-{参数规模}-{patch大小}-{输入图片分辨率}。第1个参数“ViT”表示模型的架构,第2个参数表示模型的参数规模,分成B(Base,中等规模)、L(Large,大规模)和H(Huge,超大规模),让我想起咖啡的中杯、大杯和超大杯。第3个参数指的是图片被分割成的patch的大小,14表示patch的尺寸是14 * 14像素。embedding模型在处理图片时,会先把图片分割成多个patch,类似于处理文本时,先对文本分块(详见[[03-鲁迅到底说没说?RAG之分块]])。输入图片的分辨率默认为224 * 224像素,否则会通过第4个参数指定。
举个例子,“ViT-L-14-336”表示该embedding模型是ViT架构,参数规模为大规模,patch的尺寸是14 * 14,输入图片的分辨率是336 * 336。
相比于ViT系列模型,RN系列模型的命名规律简单些:RN+层数。第1个参数“RN”同样表示模型架构,第2个参数表示层数。比如,RN50表示该模型基于50层的ResNet架构。
为了方便演示,我们使用较小的“ViT-B-16”模型。通过clip.load_from_name函数下载、加载模型和预处理函数。
# 确定使用的设备:如果可用则使用GPU,否则使用CPU
device = "cuda" if torch.cuda.is_available() else "cpu"
# 指定模型名称
model_name = "ViT-B-16"
# 加载chinese-clip模型和对应的预处理函数
# model: 包含图片编码器(encode_image)和文本编码器(encode_text)
# preprocess: 图片预处理函数(包括归一化、缩放等操作)
# download_root: 设置模型下载后保存的位置
model, preprocess = clip.load_from_name(model_name, device=device, download_root='./chinese_clip_model')
# 将模型设置为评估模式,关闭dropout等训练特性
model.eval()
print("-"*50)
print(f"Model Loaded: {model_name}")
加载好embedding模型后,就可以调用它们定义向量化图片和文本的函数了。定义向量化图片的函数如下所示:
def encode_image(image_path):
    # 关闭梯度计算,减少内存消耗,提高计算效率
    with torch.no_grad():
        # 打开图片文件
        # 如果图片不是RGB格式,使用convert转换格式
        raw_image = Image.open(image_path).convert('RGB')
        processed_image = preprocess(raw_image).unsqueeze(0).to(device)
        # 生成图片的向量
        image_features = model.encode_image(processed_image)
        # 特征归一化
        image_features /= image_features.norm(dim=-1, keepdim=True)
        # 以列表形式返回向量
        return image_features.squeeze().tolist()
定义向量化文本的函数如下所示:
def encode_text(text_list):
    # 关闭梯度计算,减少内存消耗,提高计算效率
    with torch.no_grad():
        # 文本分词和特殊符号处理
        text_tokens = clip.tokenize(text_list).to(device)
        # 生成文本的向量
        text_features = model.encode_text(text_tokens)
        # 特征归一化
        text_features /= text_features.norm(dim=-1, keepdim=True)
        # 以列表形式返回向量
        return [f.squeeze().tolist() for f in text_features]
(4)插入数据
接下来,调用上一步中定义的函数,分批次把图片向量化并且插入到Milvus中。插入数据的函数如下所示:
# 定义插入数据的函数
import os
from glob import glob
from tqdm import tqdm
import time
# 进度条显示一个变化的进度条,而不是多个不同进度的进度条
def process_images_and_insert(input_dir_path, ext_list, batch_size=100):
    # 获取所有JPEG文件路径(递归图片检索)
    image_paths = []
    for ext in ext_list:
        image_paths.extend(glob(os.path.join(input_dir_path, f"**/{ext}"), recursive=True))
    total_images = len(image_paths)
    print(f"总计需要处理 {total_images} 张图片")
    # 初始化总计时器
    total_start_time = time.time()
    # 初始化进度条
    with tqdm(total=total_images, desc="处理图片并插入数据") as progress_bar:
        # 分批处理图片
        for batch_start in range(0, total_images, batch_size):
            batch_data = []
            batch_paths = image_paths[batch_start: batch_start + batch_size]
            batch_start_time = time.time()
            # 当前批次的向量化处理
            for image_path in batch_paths:
                try:
                    image_embedding = encode_image(image_path)
                    batch_data.append({
                        "vectors": image_embedding,
                        "filepath": image_path
                    })
                except Exception as e:
                    print(f"处理图片 {image_path} 时出错: {str(e)}")
                    continue
            # 批量插入当前批次到Milvus
            if batch_data:
                try:
                    res = milvus_client.insert(
                        collection_name=collection_name,
                        data=batch_data
                    )
                    # 计算批次耗时
                    batch_duration = time.time() - batch_start_time
                    # 更新进度条:每次成功插入的图片数量
                    progress_bar.update(len(batch_data))
                    # 显示批次处理时间
                    progress_bar.set_postfix({
                        "批次耗时": batch_duration,
                    })
                except Exception as e:
                    print(f"插入批次 {batch_start} 时失败: {str(e)}")
    # 计算总耗时
    total_duration = time.time() - total_start_time
    print(f"\n所有图片处理完成!总耗时: total_duration)")
    print(f"平均处理速度: {total_images/total_duration:.1f}张/秒")
分批插入数据:
# 插入数据
input_dir_path = "lhq_1024_jpg_5000"
# 每批处理数量
batch_size = 300
ext_list = ['*.JPEG', '*.jpg', '*.png']
process_images_and_insert(input_dir_path, ext_list, batch_size)
(5)创建索引并且加载集合
数据插入成功后,还需要创建索引。使用倒排索引(IVF_FLAT),检索效率高,准确性也不错。度量方式使用余弦相似度(COSINE)。
# 定义创建索引的函数
def create_index(collection_name):
    # 准备索引参数
    index_params = milvus_client.prepare_index_params()
    index_params.add_index(
        index_name="IVF_FLAT",
        # 指定创建索引的字段
        field_name="vectors",
        index_type="IVF_FLAT",
        metric_type="COSINE",
        params={"nlist":512}
    )
    # 创建索引
    milvus_client.create_index(
        collection_name=collection_name,
        index_params=index_params
    )
create_index(collection_name)
索引创建完成后,需要把集合加载到内存中,这样才能检索。
# 加载集合
print(f"正在加载集合 {collection_name}")
milvus_client.load_collection(collection_name=collection_name)
print(f"集合 {collection_name} 加载完成")
集合加载成功了吗?验证下看看。
# 验证加载状态
state = str(milvus_client.get_load_state(collection_name=collection_name)['state'])
if state == 'Loaded':
    print("集合加载完成")
else:
    print("集合加载失败")
数据集中有5000条数据,查看集合中的数据数量是否正确。
print(milvus_client.query(
    collection_name=collection_name,
    output_fields=["count(*)"]
    )
)
如果一切正常,返回内容应该是这样的:
data: ["{'count(*)': 5000}"]
03 结果展示
使用Chinese-CLIP可以实现以文搜图以及以图搜图,其实本质都是相同的,都是根据查询(文字或者图片)生成查询向量,再从Milvus中检索与查询向量最接近的图片的向量,最后返回该图片。先来试试以文搜图吧。
以文搜图
首先定义图片检索函数。输入查询向量(vector)、图片检索的字段(field_name)、返回结果的数量(limit)以及输出的字段(output_fields),返回图片检索结果。
# 定义图片检索函数
def vector_search(vector, field_name, limit, output_fields):
    # 执行向量图片检索
    res = milvus_client.search(
        collection_name=collection_name,
        data=vector,
        anns_field=field_name,
        limit=limit,
        output_fields=output_fields
    )
    return res
然后就可以检索了。以马致远的《天净沙·秋思》为例,看看分别能检索出什么图片。先开看看第一句,“枯藤老树昏鸦”。
# 以文搜图
query_text = ["枯藤老树昏鸦"]
query_embedding = encode_text(query_text)[0]
field_name = "vectors"
limit = 10
output_fields = ["filepath"]
res = vector_search([query_embedding], field_name, limit, output_fields)
得到检索结果后,还需要定义一个显示图片检索结果(也就是图片)的函数,方便查看。
from IPython.display import display
from PIL import Image
# 定义显示图片检索结果的函数
def create_concatenated_image(res, images_per_row=2, images_per_column=2, image_size=(400, 400)):
    # 设置拼接后的大图尺寸:
    width = image_size[0] * images_per_row
    height = image_size[1] * images_per_column
    # 创建一个空白的大画布(RGB模式,白色背景)
    concatenated_image = Image.new("RGB", (width, height))
    # 存储所有结果图片的列表
    result_images = []
    # 遍历图片检索结果的每个hit对象(res是包含多个batch的列表)
    for result in res:  # 通常res是单batch列表
        for hit in result:
            # 从hit对象中获取图片文件路径
            filename = hit["entity"]["filepath"]
            # 打开图片文件并调整大小为指定尺寸
            img = Image.open(filename)
            # 保持宽高比的缩略图
            img = img.resize(image_size)
            # 将处理后的图片添加到列表
            result_images.append(img)
    # 将缩略图拼接到大画布上
    for idx, img in enumerate(result_images):
        # 计算当前图片应放置的网格位置:
        # 列索引(每行显示images_per_row张图)
        x = idx % images_per_row
        # 行索引(整数除法)
        y = idx // images_per_row
        # 将图片粘贴到计算好的位置
        concatenated_image.paste(img, (x * image_size[0], y * image_size[1]))
    return concatenated_image
执行该函数,查看检索结果:
# 查询文本
print(f"查询文本: {query_text}")
# 图片检索结果
print(f"检索结果:")
display(create_concatenated_image(res, 2, 2, (400, 400)))
返回的结果应该是这样的:
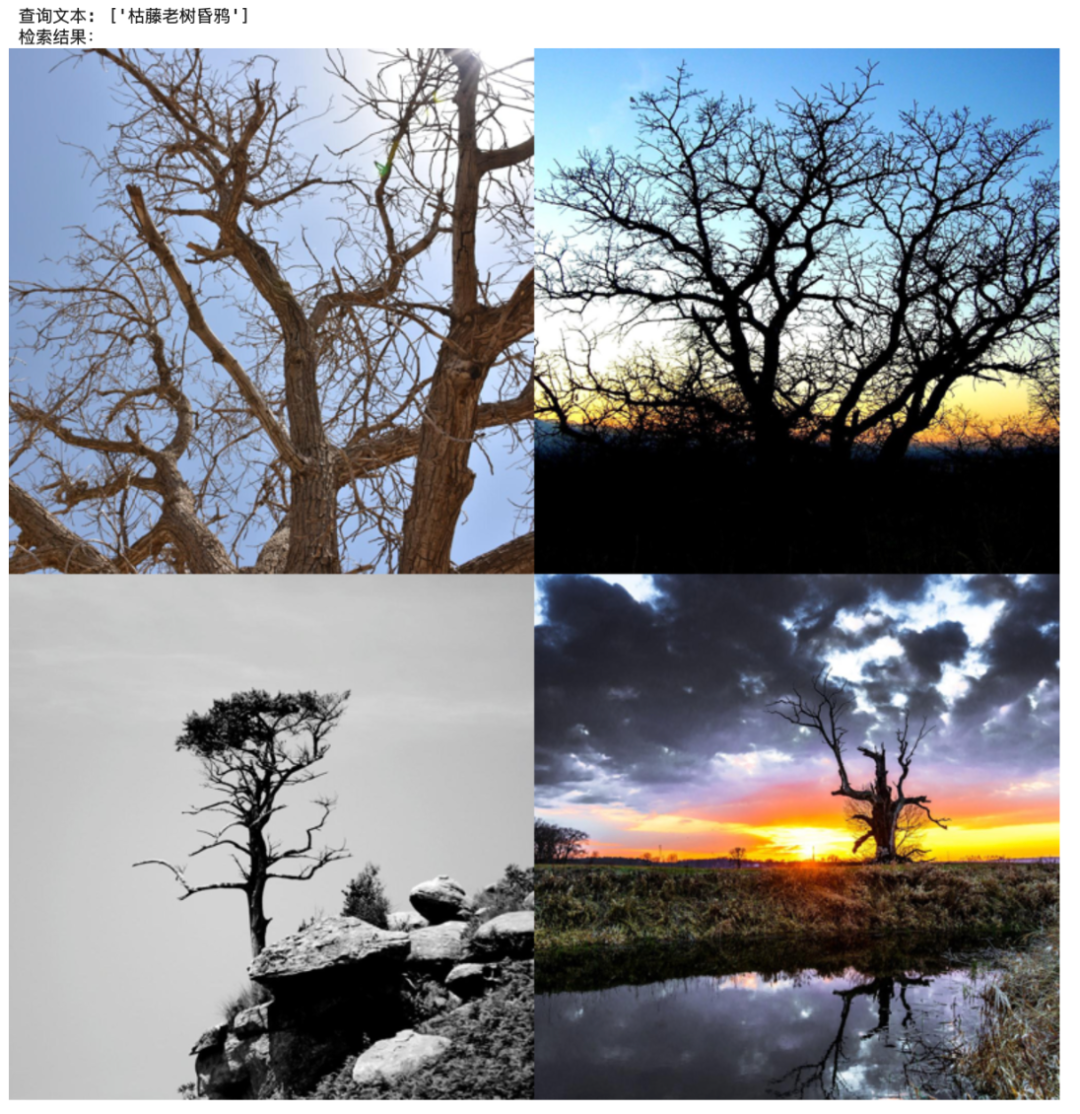
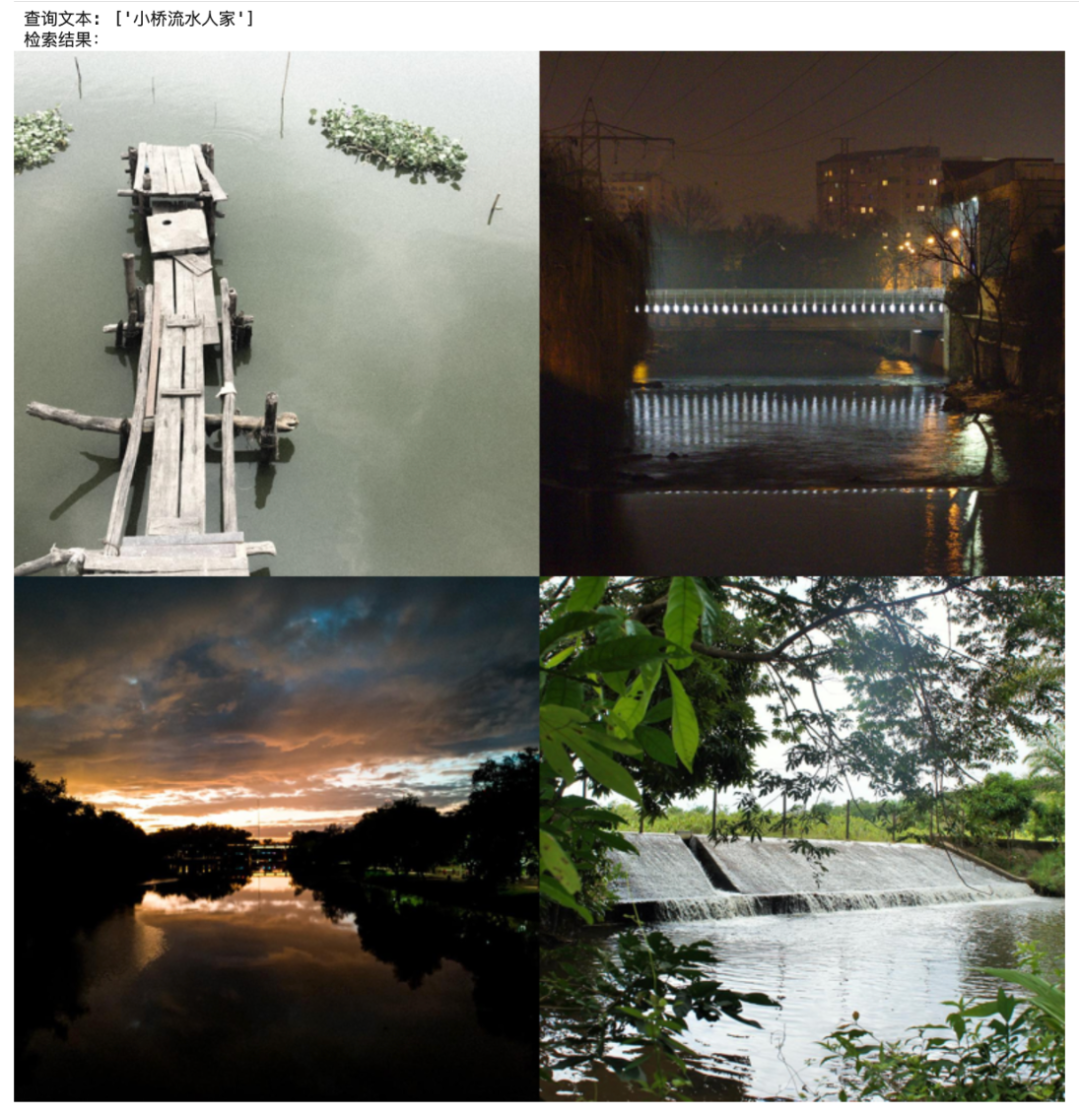
我觉得这些图片的意境还蛮符合的,你觉得怎么样?我们再来试试其他句子,检索“小桥流水人家”:
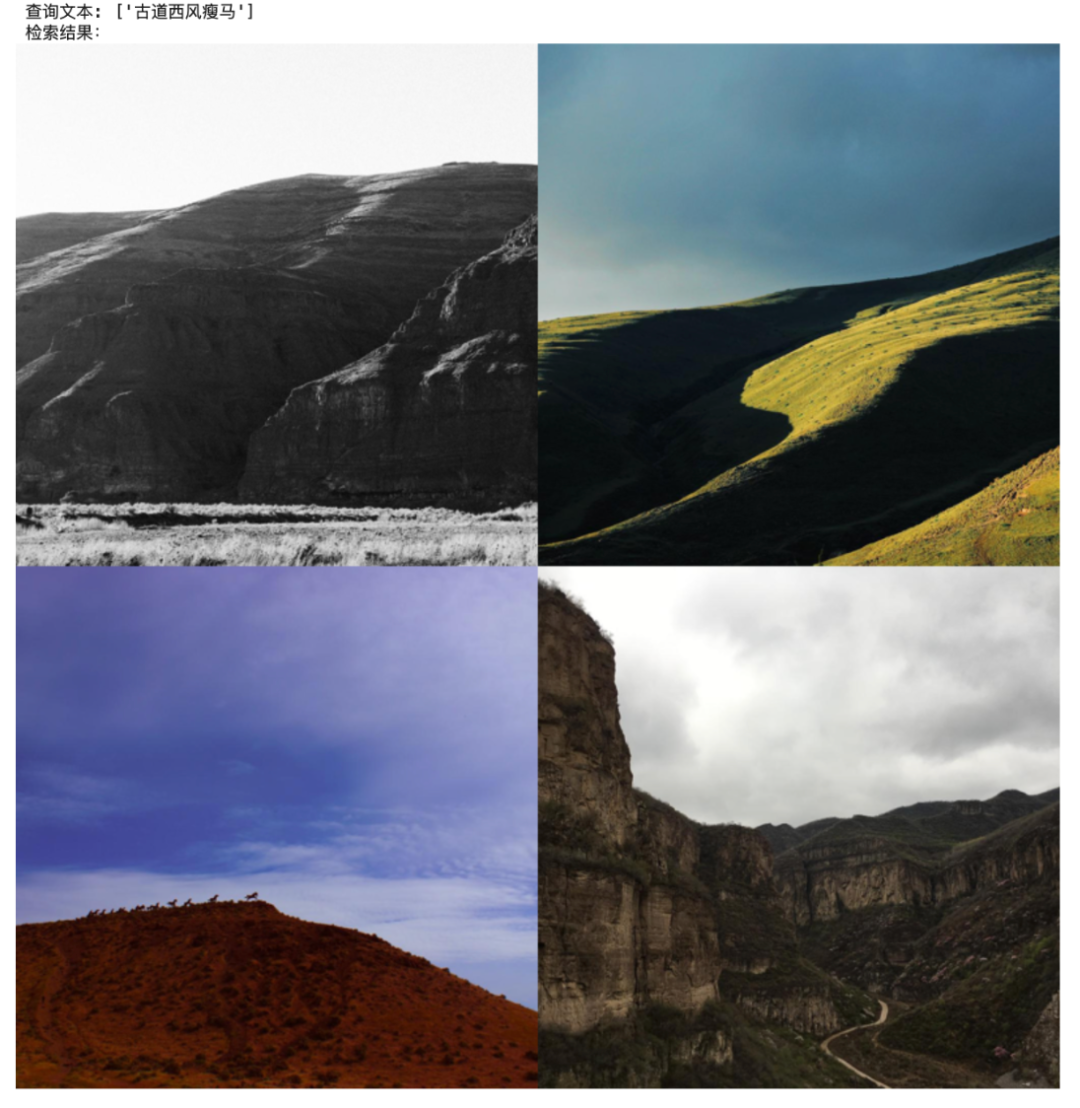
检索“古道西风瘦马”:
检索“夕阳西下”:
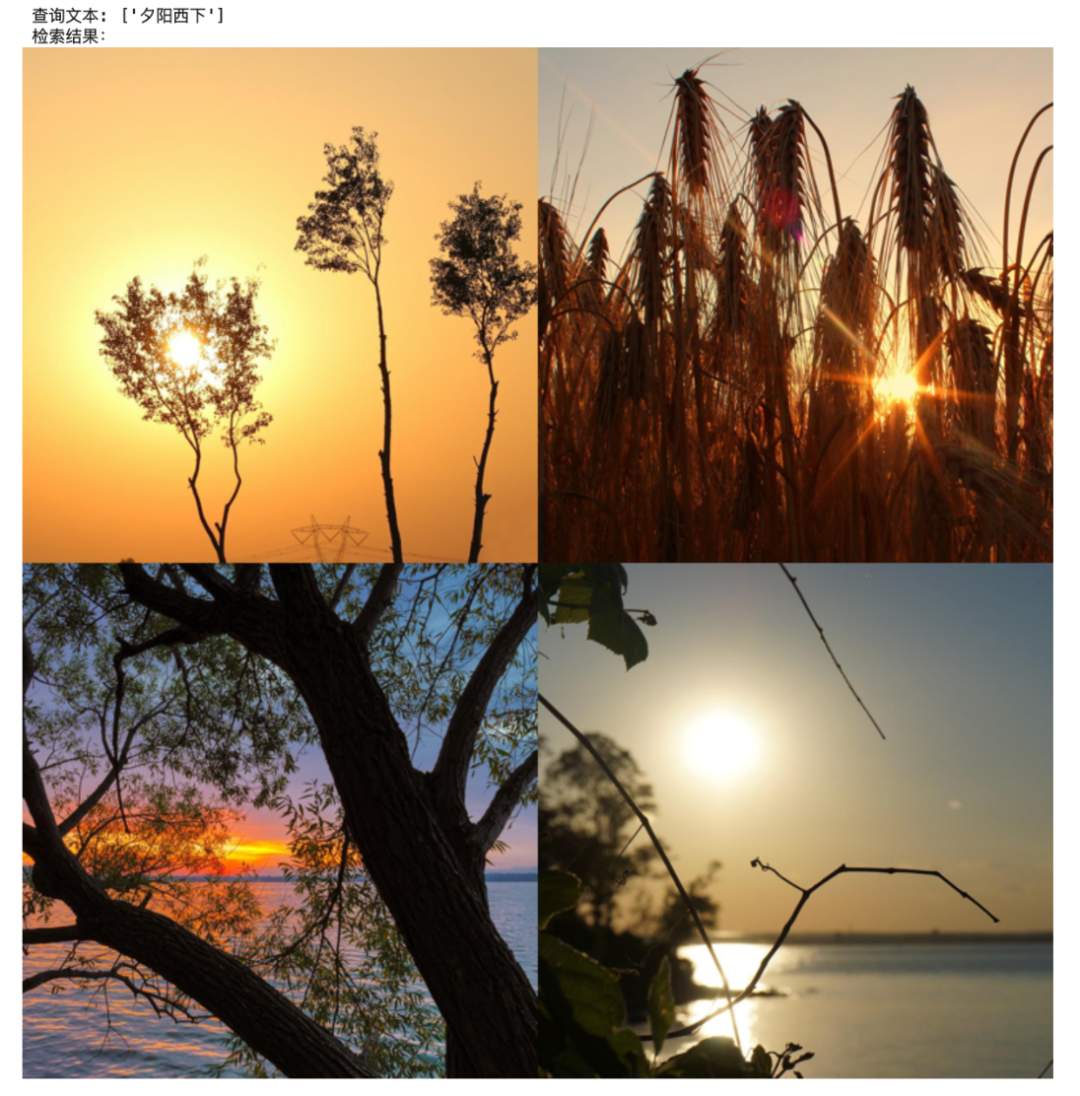
检索“断肠人在天涯”:
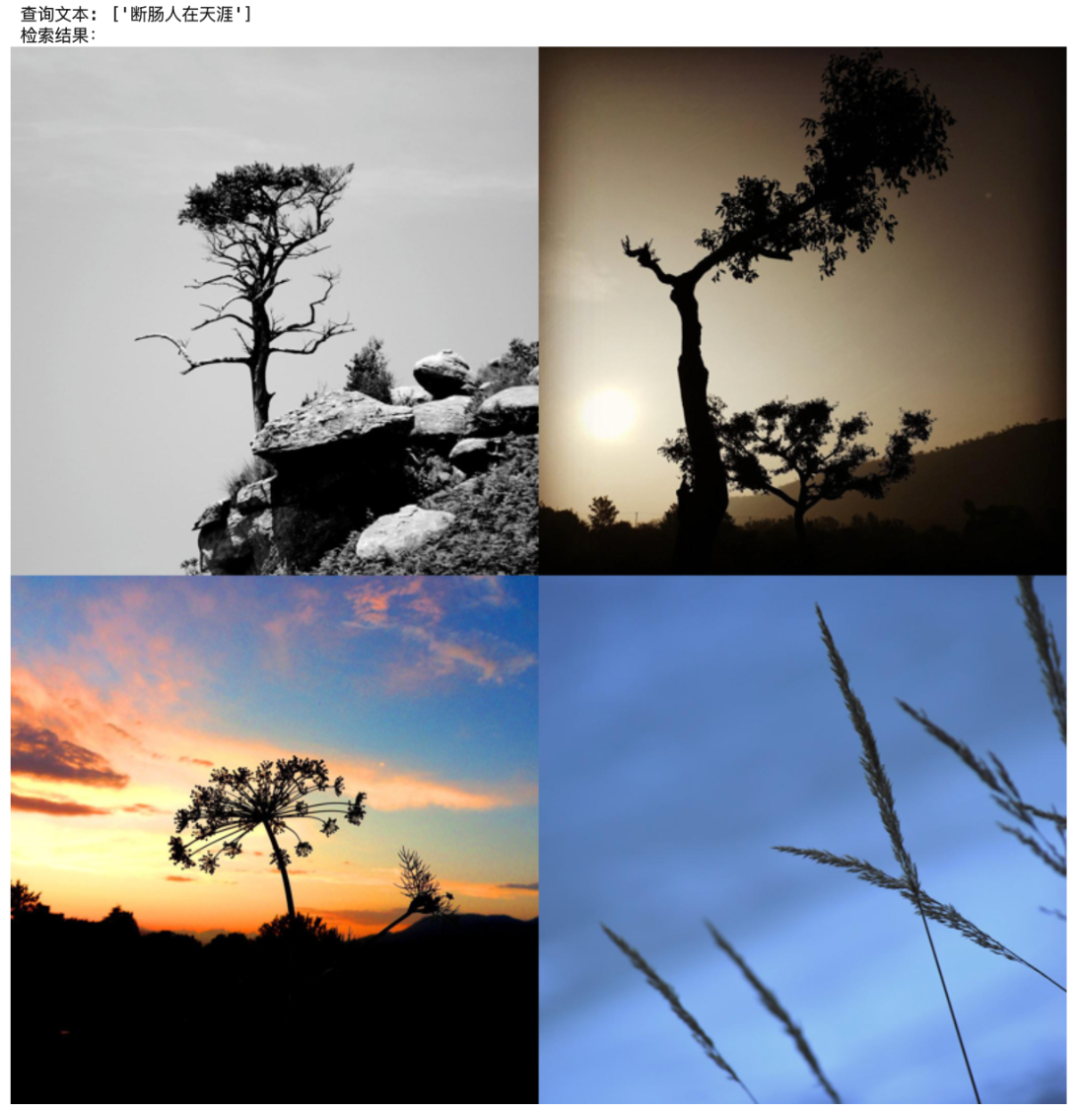
说实话,我对后半段的检索结果并不是十分满意,比如“古道西风瘦马”里面没有马,“断肠人在天涯”中也没有人。
为什么会这样?
有多个原因会导致这样的结果,比如数据集没根本就没有和查询概念相近的图片,还有可能是embedding模型没有的文本和图片编码器的特征空间没有充分对齐,也就是说概念相近的文本和图片生成的向量,在向量空间中的距离并不靠近。这种情况需要提供更多数据来做微调。
以图搜图
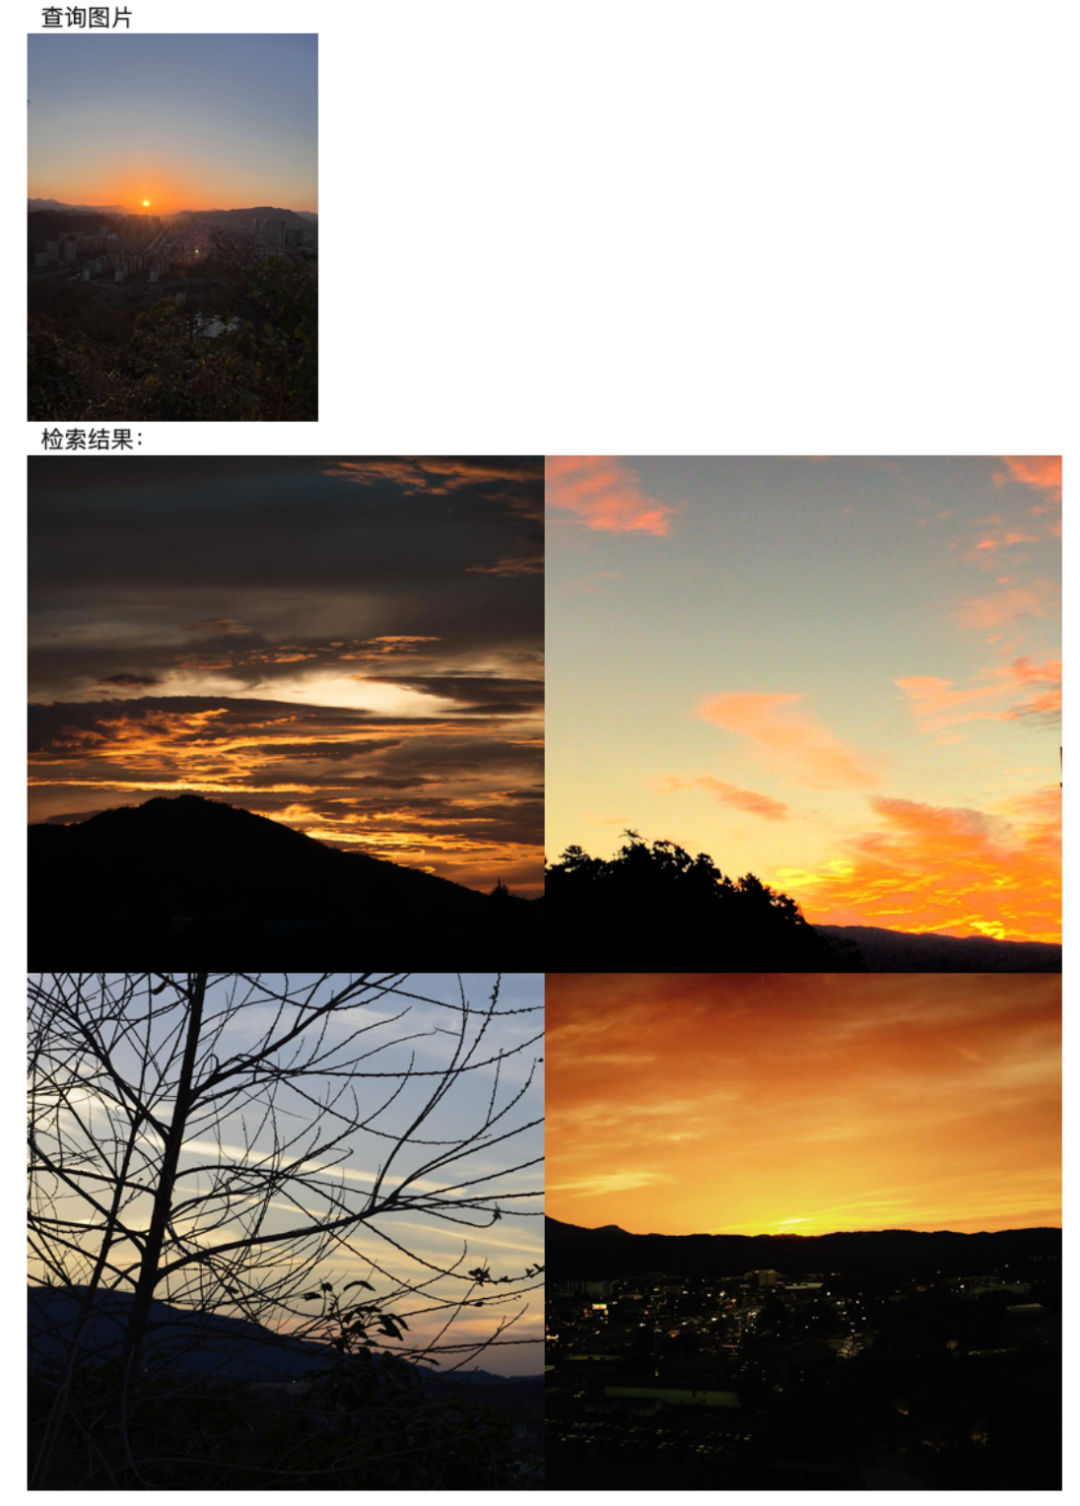
尝试了以文搜图,再来试试以图搜图吧。我随手拍了一张夕阳西下的照片作为查询。为了显示查询内容,还需要定义一个显示查询图片的函数show_single_image:
# 显示查询图片
def show_single_image(image_path, image_size=(300, 300)):
    # 打开图片
    img = Image.open(image_path)
    # 保持宽高比的前提下缩小图片,图片缩小后的最大值不超过指定值
    img.thumbnail(image_size)
    # 缩放图片到指定尺寸
    # img = img.resize(image_size)
    # 显示图片
    display(img)
检索与查询图片相似的图片:
# 定义查询图片
query_image = 'query_image.jpg'
query_embedding = encode_image(query_image)
field_name = "vectors"
limit = 10
output_fields = ["filepath"]
res = vector_search([query_embedding], field_name, limit, output_fields)
显示检索结果:
# 查询图片
print(f"查询图片")
show_single_image(query_image)
# 图片检索结果
print(f"图片检索结果:")
concatenated_image = create_concatenated_image(res)
display(concatenated_image)
虽然返回的图片与之前用文本“夕阳西下”搜索的结果并不相同,但整体画面内容仍然相近。
04 总结
和单一模态的embedding模型相比,多模态embedding模型可以同时处理多种类型的数据。除了以文搜图,我们还能实现以文搜视频,以图搜视频等等方式。
这对多数企业来说意义非凡。长期来看,企业掌握的数据早已不再局限于过去的结构化报表。合同、客服通话、监控视频、设计图纸、培训录音——90% 以上的企业数据都是非结构化的。
自然语言查询(Natural Language Query)与多模态 embedding 模型的兴起,提供了处理非结构化数据的解决路径。前者让用户可以用自然语言向系统提问,极大降低了数据使用门槛。而后者则进一步打破了文本、图像、音频等数据孤岛,实现真正的语义级理解与搜索。
未来,无论是合规团队想查询“最近半年所有涉及 ESG 风险的合同条款”,还是产品经理希望定位“用户提到‘卡顿’但未使用关键词‘卡慢’的视频录屏”,都可以通过一句话完成调用。
这不仅是一次搜索体验的升级,更是组织知识管理范式的转变。